آموزش هوش مصنوعی با پایتون - یادگیری بدون نظارت (خوشهبندی)
الگوریتمهای یادگیری ماشین بدون نظارت، هیچگونه ناظری برای ارائه راهنمایی ندارند. به همین دلیل است که آنها شباهت زیادی به آنچه برخی آن را هوش مصنوعی واقعی مینامند، دارند.
در یادگیری بدون نظارت، هیچ پاسخ درستی وجود ندارد و هیچ آموزگاری برای راهنمایی نیست. الگوریتمها برای یادگیری باید الگوهای جالب را در دادهها کشف کنند.
خوشهبندی چیست؟
به طور کلی، خوشهبندی نوعی روش یادگیری بدون نظارت و یک تکنیک رایج برای تحلیل دادههای آماری است که در بسیاری از زمینهها استفاده میشود. خوشهبندی عمدتاً وظیفه تقسیم یک مجموعه از مشاهدات به زیرمجموعههایی به نام خوشه (Cluster) است، به طوری که مشاهدات موجود در یک خوشه از یک جهت با هم شباهت داشته باشند و با مشاهدات موجود در خوشههای دیگر متفاوت باشند. به زبان ساده، میتوان گفت هدف اصلی خوشهبندی، گروهبندی دادهها بر اساس شباهت و عدم شباهت است.
برای مثال، نمودار زیر دادههای مشابه را در خوشههای مختلف نشان میدهد −
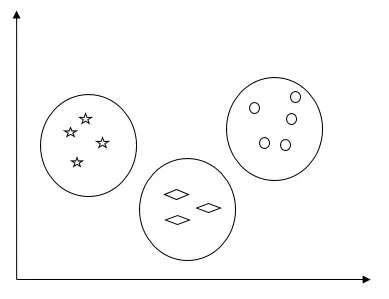
الگوریتمهای خوشهبندی دادهها
در ادامه چند الگوریتم رایج برای خوشهبندی دادهها آورده شده است −
الگوریتم K-Means
الگوریتم خوشهبندی K-means یکی از الگوریتمهای شناختهشده برای خوشهبندی دادهها است. ما باید فرض کنیم که تعداد خوشهها از قبل مشخص است. به این نوع خوشهبندی، خوشهبندی مسطح (Flat clustering) نیز میگویند. این یک الگوریتم خوشهبندی تکرار شونده است. گامهای زیر باید برای این الگوریتم دنبال شوند −
گام ۱ − ما باید تعداد زیرگروههای دلخواه K را مشخص کنیم.
گام ۲ − تعداد خوشهها را ثابت کرده و هر نقطه داده را به طور تصادفی به یک خوشه اختصاص دهیم. یا به عبارت دیگر باید دادههای خود را بر اساس تعداد خوشهها دستهبندی کنیم.
در این گام، مرکز خوشهها (Centroids) باید محاسبه شوند.
از آنجا که این یک الگوریتم تکرار شونده است، ما باید موقعیتهای K مرکز خوشه را در هر تکرار بهروزرسانی کنیم تا زمانی که به بهینهسازی سراسری برسیم یا به عبارت دیگر مراکز خوشهها به موقعیت بهینه خود برسند.
کد زیر به پیادهسازی الگوریتم خوشهبندی K-means در پایتون کمک میکند. ما قرار است از ماژول Scikit-learn استفاده کنیم.
بیا پکیجهای لازم را وارد کنیم −
import matplotlib.pyplot as plt
import seaborn as sns; sns.set()
import numpy as np
from sklearn.cluster import KMeans
خط کد زیر به تولید یک مجموعه داده دو بعدی حاوی چهار لکه (Blob) با استفاده از make_blob از پکیج sklearn.dataset کمک میکند.
from sklearn.datasets.samples_generator import make_blobs

X, y_true = make_blobs(n_samples = 500, centers = 4,
            cluster_std = 0.40, random_state = 0)
ما میتوانیم مجموعه داده را با استفاده از کد زیر تجسم (Visualizing) کنیم −
plt.scatter(X[:, 0], X[:, 1], s = 50);
plt.show()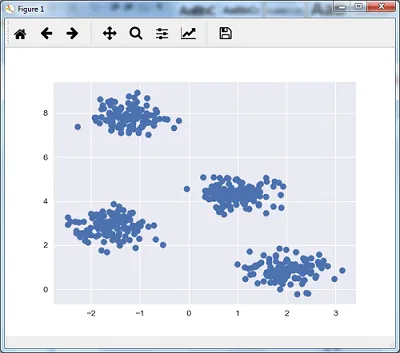
در اینجا، ما kmeans را با پارامتر مورد نیاز یعنی تعداد خوشهها (n_clusters) مقداردهی اولیه میکنیم.
kmeans = KMeans(n_clusters = 4)ما باید مدل K-means را با دادههای ورودی آموزش دهیم.
kmeans.fit(X)
y_kmeans = kmeans.predict(X)
plt.scatter(X[:, 0], X[:, 1], c = y_kmeans, s = 50, cmap = 'viridis')

centers = kmeans.cluster_centers_
کد زیر به ما کمک میکند یافتههای ماشین را بر اساس دادههای خود و انطباق آن با توجه به تعداد خوشههایی که باید یافت شوند، رسم و تجسم کنیم.
plt.scatter(centers[:, 0], centers[:, 1], c = 'black', s = 200, alpha = 0.5);
plt.show()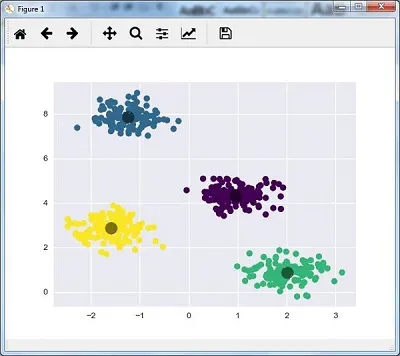
الگوریتم شیفت میانگین (Mean Shift)
این الگوریتم یکی دیگر از الگوریتمهای خوشهبندی محبوب و قدرتمند است که در یادگیری بدون نظارت استفاده میشود. این الگوریتم هیچ فرضی را در نظر نمیگیرد، بنابراین یک الگوریتم ناپارامتری است. به آن خوشهبندی سلسلهمراتبی یا تحلیل خوشهای شیفت میانگین نیز گفته میشود. گامهای پایه این الگوریتم به شرح زیر است −
-
قبل از هر چیز، باید با نقاط دادهای شروع کنیم که هر کدام به خوشه خودشان اختصاص یافتهاند.
-
سپس، مراکز خوشهها را محاسبه کرده و موقعیت مراکز جدید را بهروزرسانی میکند.
-
با تکرار این فرآیند، به قله خوشه یعنی به سمت ناحیهای با تراکم بالاتر نزدیکتر میشویم.
-
این الگوریتم در مرحلهای متوقف میشود که مراکز خوشهها دیگر جابهجا نشوند.
با کمک کد زیر، الگوریتم خوشهبندی Mean Shift را در پایتون پیادهسازی میکنیم. ما از ماژول Scikit-learn استفاده خواهیم کرد.
بیا پکیجهای لازم را وارد کنیم −
import numpy as np
from sklearn.cluster import MeanShift
import matplotlib.pyplot as plt
from matplotlib import style
style.use("ggplot")
کد زیر به تولید یک مجموعه داده دو بعدی، حاوی چهار لکه، با استفاده از make_blob از پکیج sklearn.dataset کمک میکند.
from sklearn.datasets.samples_generator import make_blobsمیتوانیم مجموعه داده را با کد زیر تجسم کنیم
centers = [[2,2],[4,5],[3,10]]
X, _ = make_blobs(n_samples = 500, centers = centers, cluster_std = 1)
plt.scatter(X[:,0],X[:,1])
plt.show()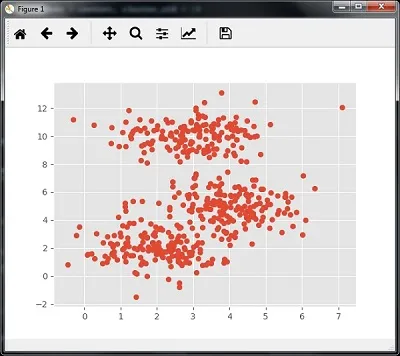
اکنون باید مدل خوشهبندی Mean Shift را با دادههای ورودی آموزش دهیم.
ms = MeanShift()
ms.fit(X)
labels = ms.labels_
cluster_centers = ms.cluster_centers_
کد زیر مراکز خوشهها و تعداد خوشههای پیشبینی شده را مطابق با دادههای ورودی چاپ میکند −
print(cluster_centers)
n_clusters_ = len(np.unique(labels))
print("Estimated clusters:", n_clusters_)
[[ 3.23005036 3.84771893]
[ 3.02057451 9.88928991]]
Estimated clusters: 2
کد زیر به رسم و تجسم یافتههای ماشین بر اساس دادههای ما و انطباق با توجه به تعداد خوشههایی که باید پیدا شوند کمک میکند.
colors = 10*['r.','g.','b.','c.','k.','y.','m.']
   for i in range(len(X)):
   plt.plot(X[i][0], X[i][1], colors[labels[i]], markersize = 10)
plt.scatter(cluster_centers[:,0],cluster_centers[:,1],
   marker = "x",color = 'k', s = 150, linewidths = 5, zorder = 10)
plt.show()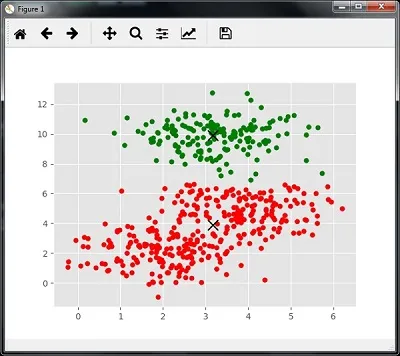
ارزیابی عملکرد خوشهبندی
دادههای دنیای واقعی به طور طبیعی به تعداد مشخصی خوشههای متمایز سازماندهی نشدهاند. به همین دلیل، تجسم و استنتاج از آنها آسان نیست. از این رو ما باید عملکرد و کیفیت خوشهبندی را اندازهگیری کنیم. این کار را میتوان با کمک تحلیل سیلوئت (Silhouette Analysis) انجام داد.
تحلیل سیلوئت (Silhouette Analysis)
از این روش میتوان برای بررسی کیفیت خوشهبندی با اندازهگیری فاصله بین خوشهها استفاده کرد. در اصل، این روش راهی برای ارزیابی پارامترهایی مانند تعداد خوشهها با ارائه امتیاز سیلوئت (Silhouette Score) فراهم میکند. این امتیاز معیاری است که نشان میدهد هر نقطه در یک خوشه چقدر به نقاط موجود در خوشههای همسایه نزدیک است.
تحلیل امتیاز سیلوئت
امتیاز در بازه [1, 1-] قرار دارد. تحلیل این امتیاز به شرح زیر است −
-
امتیاز 1+ − امتیاز نزدیک به 1+ نشان میدهد که نمونه فاصله زیادی از خوشه همسایه دارد.
-
امتیاز 0 − امتیاز 0 نشان میدهد که نمونه روی مرز تصمیمگیری بین دو خوشه همسایه یا بسیار نزدیک به آن قرار دارد.
-
امتیاز 1- − امتیاز منفی نشان میدهد که نمونهها به خوشههای اشتباهی اختصاص داده شدهاند.
محاسبه امتیاز سیلوئت
در این بخش یاد میگیریم که چگونه امتیاز سیلوئت را محاسبه کنیم.
امتیاز سیلوئت را میتوان با استفاده از فرمول زیر محاسبه کرد −
$$silhouette score = \frac{\left ( p-q \right )}{max\left ( p,q \right )}$$
در اینجا، میانگین فاصله تا نقاط نزدیکترین خوشهای است که نقطه داده عضو آن نیست. و، میانگین فاصله درونخوشهای تا تمام نقاط موجود در خوشه خودش است.
برای یافتن تعداد بهینه خوشهها، باید الگوریتم خوشهبندی را دوباره با فراخوانی ماژول metrics از پکیج sklearn اجرا کنیم. در مثال زیر، الگوریتم خوشهبندی K-means را برای یافتن تعداد بهینه خوشهها اجرا خواهیم کرد −
پکیجهای لازم را مطابق شکل وارد کنید −
import matplotlib.pyplot as plt
import seaborn as sns; sns.set()
import numpy as np
from sklearn.cluster import KMeans
با کمک کد زیر، مجموعه داده دو بعدی حاوی چهار لکه را با استفاده از make_blob از پکیج sklearn.dataset تولید میکنیم.
from sklearn.datasets.samples_generator import make_blobs

X, y_true = make_blobs(n_samples = 500, centers = 4, cluster_std = 0.40, random_state = 0)
متغیرها را مطابق شکل مقداردهی اولیه کنید −
scores = []
values = np.arange(2, 10)
ما باید مدل K-means را روی تمام مقادیر پیمایش کنیم و همچنین آن را با دادههای ورودی آموزش دهیم.
for num_clusters in values:
kmeans = KMeans(init = 'k-means++', n_clusters = num_clusters, n_init = 10)
kmeans.fit(X)
اکنون، امتیاز سیلوئت را برای مدل خوشهبندی فعلی با استفاده از معیار فاصله اقلیدسی برآورد کنید −
score = metrics.silhouette_score(X, kmeans.labels_,
metric = 'euclidean', sample_size = len(X))
خط کد زیر به نمایش تعداد خوشهها و همچنین امتیاز سیلوئت کمک میکند.
print("\nNumber of clusters =", num_clusters)
print("Silhouette score =", score)
scores.append(score)
خروجی زیر را دریافت خواهید کرد −
Number of clusters = 9
Silhouette score = 0.340391138371

num_clusters = np.argmax(scores) + values[0]
print('\nOptimal number of clusters =', num_clusters)
اکنون خروجی برای تعداد بهینه خوشهها به صورت زیر خواهد بود −
Optimal number of clusters = 2یافتن نزدیکترین همسایهها
اگر بخواهیم سیستمهای پیشنهاددهنده مانند سیستم پیشنهاد فیلم بسازیم، باید مفهوم یافتن نزدیکترین همسایهها را درک کنیم. زیرا سیستم پیشنهاددهنده از مفهوم نزدیکترین همسایهها استفاده میکند.
مفهوم یافتن نزدیکترین همسایهها را میتوان به عنوان فرآیند یافتن نزدیکترین نقطه به نقطه ورودی از مجموعه داده دادهشده تعریف کرد. استفاده اصلی از این الگوریتم KNN (K-نزدیکترین همسایه) ساخت سیستمهای دستهبندی است که یک نقطه داده را بر اساس مجاورت نقطه داده ورودی به کلاسهای مختلف دستهبندی میکند.
کد پایتون زیر به یافتن K-نزدیکترین همسایه یک مجموعه داده دادهشده کمک میکند −
پکیجهای لازم را مطابق زیر وارد کنید. در اینجا، ما از ماژول NearestNeighbors از پکیج sklearn استفاده میکنیم
import numpy as np
import matplotlib.pyplot as plt
from sklearn.neighbors import NearestNeighbors
بیا اکنون دادههای ورودی را تعریف کنیم −
A = np.array([[3.1, 2.3], [2.3, 4.2], [3.9, 3.5], [3.7, 6.4], [4.8, 1.9],
             [8.3, 3.1], [5.2, 7.5], [4.8, 4.7], [3.5, 5.1], [4.4, 2.9],])
اکنون باید نزدیکترین همسایهها را تعریف کنیم −
k = 3ما همچنین باید دادههای آزمایشی را که باید نزدیکترین همسایهها از آن پیدا شوند، ارائه دهیم −
test_data = [3.3, 2.9]کد زیر میتواند دادههای ورودی تعریفشده توسط ما را تجسم کرده و رسم کند −
plt.figure()
plt.title('Input data')
plt.scatter(A[:,0], A[:,1], marker = 'o', s = 100, color = 'black')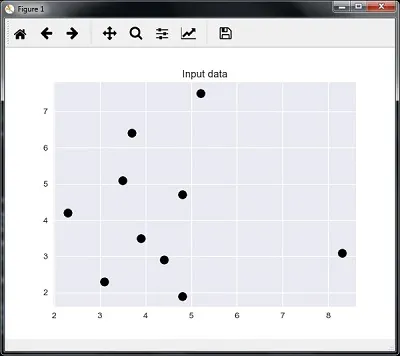
اکنون، باید K نزدیکترین همسایه را بسازیم. شیء نیز باید آموزش ببیند
knn_model = NearestNeighbors(n_neighbors = k, algorithm = 'auto').fit(X)
distances, indices = knn_model.kneighbors([test_data])
اکنون، میتوانیم K نزدیکترین همسایه را به صورت زیر چاپ کنیم
print("\nK Nearest Neighbors:")
for rank, index in enumerate(indices[0][:k], start = 1):
print(str(rank) + " is", A[index])میتوانیم نزدیکترین همسایهها را همراه با نقطه داده آزمایشی تجسم کنیم
plt.figure()
plt.title('Nearest neighbors')
plt.scatter(A[:, 0], X[:, 1], marker = 'o', s = 100, color = 'k')
plt.scatter(A[indices][0][:][:, 0], A[indices][0][:][:, 1],
   marker = 'o', s = 250, color = 'k', facecolors = 'none')
plt.scatter(test_data[0], test_data[1],
   marker = 'x', s = 100, color = 'k')
plt.show()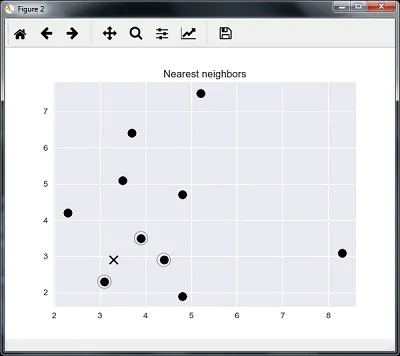
خروجی
K Nearest Neighbors
1 is [ 3.1 2.3]
2 is [ 3.9 3.5]
3 is [ 4.4 2.9]دستهبندیکننده K-نزدیکترین همسایه
یک دستهبندیکننده K-نزدیکترین همسایه (KNN) یک مدل دستهبندی است که از الگوریتم نزدیکترین همسایهها برای دستهبندی یک نقطه داده مشخص استفاده میکند. ما الگوریتم KNN را در بخش قبل پیادهسازی کردیم، اکنون قرار است با استفاده از آن الگوریتم، یک دستهبندیکننده KNN بسازیم.
مفهوم دستهبندیکننده KNN
مفهوم پایه دستهبندی K-نزدیکترین همسایه، یافتن تعداد مشخصی از نمونههای آموزش یعنی 'k' است که به لحاظ فاصله به نمونه جدیدی که باید دستهبندی شود، نزدیکترین هستند. نمونههای جدید برچسب خود را از خود همسایهها دریافت میکنند. دستهبندیکنندههای KNN دارای یک مقدار ثابت تعریفشده توسط کاربر برای تعداد همسایههایی هستند که باید تعیین شوند. برای فاصله، فاصله اقلیدسی استاندارد رایجترین انتخاب است. دستهبندیکننده KNN به جای ایجاد قوانین برای یادگیری، مستقیماً روی نمونههای یادگرفتهشده کار میکند. الگوریتم KNN یکی از سادهترین الگوریتمها در میان تمام الگوریتمهای یادگیری ماشین است. این الگوریتم در تعداد زیادی از مسائل دستهبندی و رگرسیون، به عنوان مثال، تشخیص حروف یا تحلیل تصویر بسیار موفق بوده است.
مثال
ما در حال ساخت یک دستهبندیکننده KNN برای تشخیص ارقام هستیم. برای این کار از مجموعه داده MNIST استفاده خواهیم کرد. این کد را در Jupyter Notebook خواهیم نوشت.
پکیجهای لازم را مطابق زیر وارد کنید.
در اینجا ما از ماژول KNeighborsClassifier از پکیج sklearn.neighbors استفاده میکنیم −
from sklearn.datasets import *
import pandas as pd
%matplotlib inline
from sklearn.neighbors import KNeighborsClassifier
import matplotlib.pyplot as plt
import numpy as np
کد زیر تصویر رقم را نمایش میدهد تا تأیید کند چه تصویری را باید تست کنیم −
def Image_display(i):
   plt.imshow(digit['images'][i],cmap = 'Greys_r')
   plt.show()
اکنون، باید مجموعه داده MNIST را بارگذاری کنیم. در واقع در مجموع ۱۷۹۷ تصویر وجود دارد اما ما از ۱۶۰۰ تصویر اول به عنوان نمونه آموزش استفاده میکنیم و ۱۹۷ تصویر باقیمانده برای اهداف تست نگهداری میشوند.
digit = load_digits()
digit_d = pd.DataFrame(digit['data'][0:1600])
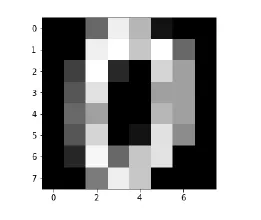
اکنون، هنگام نمایش تصاویر میتوانیم خروجی را به صورت زیر ببینیم −
Image_display(0)Image_display(0)
تصویر عدد 0 به صورت زیر نمایش داده میشود −
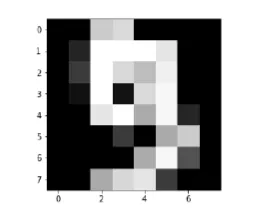
Image_display(9)
تصویر عدد 9 به صورت زیر نمایش داده میشود −
digit.keys()
اکنون، باید مجموعه دادههای آموزش و تست را ایجاد کنیم و مجموعه داده تست را به دستهبندیکنندههای KNN تحویل دهیم.
train_x = digit['data'][:1600]
train_y = digit['target'][:1600]
KNN = KNeighborsClassifier(20)
KNN.fit(train_x,train_y)
خروجی زیر سازنده دستهبندیکننده K نزدیکترین همسایه را ایجاد میکند −
KNeighborsClassifier(algorithm = 'auto', leaf_size = 30, metric = 'minkowski',
   metric_params = None, n_jobs = 1, n_neighbors = 20, p = 2,
   weights = 'uniform')
ما باید با ارائه هر عدد دلخواه بزرگتر از ۱۶۰۰ (که نمونههای آموزش بودند)، نمونه تست را ایجاد کنیم.
test = np.array(digit['data'][1725])
test1 = test.reshape(1,-1)
Image_display(1725)
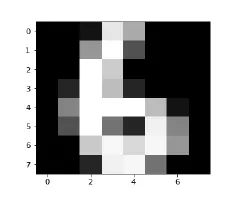
Image_display(6)
تصویر عدد 6 به صورت زیر نمایش داده میشود −
اکنون دادههای تست را به صورت زیر پیشبینی خواهیم کرد −
KNN.predict(test1)کد بالا خروجی زیر را تولید میکند −
array([6])اکنون موارد زیر را در نظر بگیرید −
digit['target_names']کد بالا خروجی زیر را تولید خواهد کرد −
array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9])پیشرفت مطالعه: وضعیت خواندهشدن این درس فقط در همین مرورگر ذخیره میشود؛ بدون نیاز به حساب کاربری.