آموزش هوش مصنوعی با پایتون - یادگیری تحت نظارت (طبقه بندی)
در این فصل، بر روی پیادهسازی یادگیری تحت نظارت − طبقه بندی تمرکز خواهیم کرد.
تکنیک یا مدل طبقهبندی تلاش میکند بر اساس مقادیر مشاهدهشده به نتیجهای دست یابد. در مسئله طبقهبندی، خروجیهای دستهبندیشدهای مانند «سیاه یا سفید» یا «آموزشی و غیرآموزشی» داریم. هنگام ساخت مدل طبقهبندی، به یک مجموعه داده آموزش نیاز داریم که شامل نقاط داده و برچسبهای مربوط به آنها باشد. برای مثال، اگر بخواهیم بررسی کنیم که آیا یک تصویر مربوط به خودرو است یا خیر، مجموعه داده آموزشی میسازیم که دارای دو کلاس مربوط به «خودرو» و «غیر خودرو» باشد. سپس باید مدل را با استفاده از نمونههای آموزشی آموزش دهیم. مدلهای طبقهبندی عمدتاً در تشخیص چهره، شناسایی اسپم و غیره استفاده میشوند.
مراحل ساخت یک طبقه بند در پایتون
برای ساخت یک طبقهبند در پایتون، از پایتون ۳ و Scikit-learn که ابزاری برای یادگیری ماشین است استفاده میکنیم. برای ساخت طبقهبند در پایتون مراحل زیر را دنبال کنید −
مرحله ۱ − فراخوانی Scikit-learn
این اولین مرحله برای ساخت طبقهبند در پایتون خواهد بود. در این مرحله، بسته پایتونی به نام Scikit-learn را که یکی از بهترین ماژولهای یادگیری ماشین در پایتون است نصب میکنیم. دستور زیر به ما در فراخوانی این بسته کمک میکند −
Import Sklearnمرحله ۲ − فراخوانی مجموعه داده Scikit-learn
در این مرحله، میتوانیم کار روی مجموعه داده را برای مدل یادگیری ماشین خود آغاز کنیم. در اینجا، از مجموعه داده تشخیصی سرطان سینه ویسکانسین استفاده خواهیم کرد. این مجموعه داده شامل اطلاعات مختلفی درباره تومورهای سرطان سینه و همچنین برچسبهای طبقهبندی بدخیم (malignant) یا خوشخیم (benign) است. این مجموعه داده دارای ۵۶۹ نمونه یا داده درباره ۵۶۹ تومور است و شامل اطلاعاتی درباره ۳۰ ویژگی یا صفت مانند شعاع تومور، بافت، همواری و مساحت میباشد. با کمک دستور زیر میتوانیم مجموعه داده سرطان سینه Scikit-learn را فراخوانی کنیم −
from sklearn.datasets import load_breast_cancerاکنون دستور زیر مجموعه داده را بارگذاری میکند.
data = load_breast_cancer()در ادامه لیستی از کلیدهای مهم دیکشنری آورده شده است −
- نام برچسبهای طبقهبندی (target_names)
- برچسبهای واقعی (target)
- نام ویژگیها/صفتها (feature_names)
- ویژگیها یا دادهها (data)
حال با کمک دستورات زیر، میتوانیم متغیرهای جدیدی برای هر مجموعه اطلاعات مهم ایجاد کنیم و دادهها را به آنها اختصاص دهیم. به عبارت دیگر، میتوانیم دادهها را با دستورات زیر سازماندهی کنیم −
label_names = data['target_names']
labels = data['target']
feature_names = data['feature_names']
features = data['data']
اکنون برای روشنتر شدن موضوع، میتوانیم برچسبهای کلاس، برچسب اولین نمونه داده، نام ویژگیهای خود و مقدار ویژگیها را با کمک دستورات زیر چاپ کنیم −
print(label_names)دستور بالا نام کلاسها را که به ترتیب بدخیم و خوشخیم هستند چاپ میکند. این خروجی در زیر نشان داده شده است −
['malignant' 'benign']اکنون دستور زیر نشان میدهد که آنها به مقادیر باینری ۰ و ۱ نگاشت شدهاند. در اینجا ۰ نشاندهنده سرطان بدخیم و ۱ نشاندهنده سرطان خوشخیم است. خروجی زیر را دریافت خواهید کرد −
print(labels[0])
0
دو دستور زیر نام ویژگیها و مقادیر ویژگیها را تولید میکنند.
print(feature_names[0])
mean radius
print(features[0])
[ 1.79900000e+01 1.03800000e+01 1.22800000e+02 1.00100000e+03
  1.18400000e-01 2.77600000e-01 3.00100000e-01 1.47100000e-01
  2.41900000e-01 7.87100000e-02 1.09500000e+00 9.05300000e-01
  8.58900000e+00 1.53400000e+02 6.39900000e-03 4.90400000e-02
  5.37300000e-02 1.58700000e-02 3.00300000e-02 6.19300000e-03
  2.53800000e+01 1.73300000e+01 1.84600000e+02 2.01900000e+03
  1.62200000e-01 6.65600000e-01 7.11900000e-01 2.65400000e-01
  4.60100000e-01 1.18900000e-01]
از خروجی بالا میتوانیم ببینیم که اولین نمونه داده، یک تومور بدخیم است که شعاع آن 1.7990000e+01 میباشد.
مرحله ۳ − سازماندهی داده ها به مجموعهها
در این مرحله، دادههای خود را به دو بخش یعنی مجموعه آموزش و مجموعه آزمون تقسیم میکنیم. تقسیم دادهها به این مجموعهها بسیار مهم است، زیرا باید مدل خود را روی دادههای دیده نشده ارزیابی کنیم. برای تقسیم دادهها به مجموعهها، sklearn تابعی به نام train_test_split() دارد. با کمک دستورات زیر میتوانیم دادهها را در این مجموعهها تقسیم کنیم −
from sklearn.model_selection import train_test_splitدستور بالا تابع train_test_split را از sklearn فراخوانی میکند و دستور زیر دادهها را به دادههای آموزشی و آزمایشی تقسیم میکند. در مثال زیر، ما از ۴۰ درصد دادهها برای آزمایش استفاده میکنیم و مابقی دادهها برای آموزش مدل استفاده خواهند شد.
train, test, train_labels, test_labels = train_test_split(features,labels,test_size = 0.40, random_state = 42)مرحله ۴ − ساخت مدل
در این مرحله، مدل خود را خواهیم ساخت. ما قصد داریم از الگوریتم بیز ساده (Naive Bayes) برای ساخت مدل استفاده کنیم. دستورات زیر برای ساخت مدل استفاده میشوند −
from sklearn.naive_bayes import GaussianNBدستور بالا ماژول GaussianNB را فراخوانی میکند. اکنون دستور زیر به شما کمک میکند مدل را مقداردهی اولیه کنید.
gnb = GaussianNB()ما مدل را با برازش آن روی دادهها با استفاده از ()gnb.fit آموزش خواهیم داد.
model = gnb.fit(train, train_labels)مرحله ۵ − ارزیابی مدل و دقت آن
در این مرحله، قصد داریم مدل را با انجام پیشبینی روی دادههای آزمایشی ارزیابی کنیم. سپس دقت آن را نیز به دست خواهیم آورد. برای انجام پیشبینیها، از تابع ()predict استفاده میکنیم. دستور زیر به شما در انجام این کار کمک میکند −
preds = gnb.predict(test)
print(preds)

[1 0 0 1 1 0 0 0 1 1 1 0 1 0 1 0 1 1 1 0 1 1 0 1 1 1 1 1 1
 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1 1 0
 0 1 1 0 0 1 1 1 0 0 1 1 0 0 1 0 1 1 1 1 1 1 0 1 1 0 0 0 0
 0 1 1 1 1 1 1 1 1 0 0 1 0 0 1 0 0 1 1 1 0 1 1 0 1 1 0 0 0
 1 1 1 0 0 1 1 0 1 0 0 1 1 0 0 0 1 1 1 0 1 1 0 0 1 0 1 1 0
 1 0 0 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0
 1 1 0 1 1 1 1 1 1 0 0 0 1 1 0 1 0 1 1 1 1 0 1 1 0 1 1 1 0
 1 0 0 1 1 1 1 1 1 1 1 0 1 1 1 1 1 0 1 0 0 1 1 0 1]
سری بالا از اعداد ۰ و ۱، مقادیر پیشبینیشده برای کلاسهای تومور یعنی بدخیم و خوشخیم هستند.
اکنون با مقایسه دو آرایه یعنی test_labels و preds، میتوانیم دقت مدل خود را به دست آوریم. ما قصد داریم از تابع accuracy_score() برای تعیین دقت استفاده کنیم. دستور زیر را برای این منظور در نظر بگیرید −
from sklearn.metrics import accuracy_score
print(accuracy_score(test_labels,preds))
0.951754385965
نتیجه نشان میدهد که طبقهبند بیز ساده دارای دقت ۹۵.۱۷٪ است.
به این ترتیب، با کمک مراحل بالا میتوانیم طبقهبند خود را در پایتون بسازیم.
ساخت طبقه بند در پایتون
در این بخش، نحوه ساخت یک طبقهبند در پایتون را خواهیم آموخت.
طبقه بند بیز ساده (Naive Bayes)
بیز ساده یک تکنیک طبقهبندی است که برای ساخت طبقهبند با استفاده از قضیه بیز استفاده میشود. فرض بر این است که پیشبینیکنندهها مستقل هستند. به زبان ساده، فرض میکند که حضور یک ویژگی خاص در یک کلاس به حضور هر ویژگی دیگری نامربوط است. برای ساخت طبقهبند بیز ساده، باید از کتابخانه پایتون به نام scikit learn استفاده کنیم. سه نوع مدل بیز ساده به نامهای Gaussian، Multinomial و Bernoulli در بسته scikit learn وجود دارد.
برای ساخت مدل طبقهبند یادگیری ماشین بیز ساده، به موارد زیر نیاز داریم −
مجموعه داده
ما قصد داریم از مجموعه دادهای به نام Breast Cancer Wisconsin Diagnostic Database استفاده کنیم. این مجموعه داده شامل اطلاعات مختلفی درباره تومورهای سرطان سینه و همچنین برچسبهای طبقهبندی بدخیم یا خوشخیم است. مجموعه داده دارای ۵۶۹ نمونه یا داده درباره ۵۶۹ تومور است و شامل اطلاعاتی درباره ۳۰ ویژگی یا صفت مانند شعاع تومور، بافت، همواری و مساحت میباشد. ما میتوانیم این مجموعه داده را از بسته sklearn فراخوانی کنیم.
مدل بیز ساده
برای ساخت طبقهبند بیز ساده، به یک مدل بیز ساده نیاز داریم. همانطور که قبلاً گفته شد، سه نوع مدل بیز ساده به نامهای Gaussian، Multinomial و Bernoulli در بسته scikit learn وجود دارد. در اینجا، در مثال زیر قصد داریم از مدل گاوسی بیز ساده (Gaussian Naive Bayes) استفاده کنیم.
با استفاده از موارد بالا، قصد داریم یک مدل یادگیری ماشین بیز ساده بسازیم تا از اطلاعات تومور برای پیشبینی بدخیم یا خوشخیم بودن تومور استفاده کنیم.
برای شروع، باید ماژول sklearn را نصب کنیم. این کار با کمک دستور زیر قابل انجام است −
Import Sklearnاکنون باید مجموعه دادهای به نام Breast Cancer Wisconsin Diagnostic Database را فراخوانی کنیم.
from sklearn.datasets import load_breast_cancerاکنون دستور زیر مجموعه داده را بارگذاری میکند.
data = load_breast_cancer()دادهها را میتوان به صورت زیر سازماندهی کرد −
label_names = data['target_names']
labels = data['target']
feature_names = data['feature_names']
features = data['data']
اکنون برای روشنتر شدن موضوع، میتوانیم برچسبهای کلاس، برچسب اولین نمونه داده، نام ویژگیهای خود و مقدار ویژگیها را با کمک دستورات زیر چاپ کنیم −
print(label_names)دستور بالا نام کلاسها را که به ترتیب بدخیم و خوشخیم هستند چاپ میکند. این خروجی در زیر نشان داده شده است −
['malignant' 'benign']اکنون دستور دادهشده در زیر نشان میدهد که آنها به مقادیر باینری ۰ و ۱ نگاشت شدهاند. در اینجا ۰ نشاندهنده سرطان بدخیم و ۱ نشاندهنده سرطان خوشخیم است. این خروجی در زیر نشان داده شده است −
print(labels[0])
0
دو دستور زیر نام ویژگیها و مقادیر ویژگیها را تولید میکنند.
print(feature_names[0])
mean radius
print(features[0])

[ 1.79900000e+01 1.03800000e+01 1.22800000e+02 1.00100000e+03
  1.18400000e-01 2.77600000e-01 3.00100000e-01 1.47100000e-01
  2.41900000e-01 7.87100000e-02 1.09500000e+00 9.05300000e-01
  8.58900000e+00 1.53400000e+02 6.39900000e-03 4.90400000e-02
  5.37300000e-02 1.58700000e-02 3.00300000e-02 6.19300000e-03
  2.53800000e+01 1.73300000e+01 1.84600000e+02 2.01900000e+03
  1.62200000e-01 6.65600000e-01 7.11900000e-01 2.65400000e-01
  4.60100000e-01 1.18900000e-01]
از خروجی بالا میتوانیم ببینیم که اولین نمونه داده، یک تومور بدخیم است که شعاع اصلی آن 1.7990000e+01 میباشد.
برای آزمایش مدل خود روی دادههای دیده نشده، باید دادههای خود را به دادههای آموزشی و آزمایشی تقسیم کنیم. این کار با کمک کد زیر قابل انجام است −
from sklearn.model_selection import train_test_splitدستور بالا تابع train_test_split را از sklearn فراخوانی میکند و دستور زیر دادهها را به دادههای آموزشی و آزمایشی تقسیم میکند. در مثال زیر، ما از ۴۰ درصد دادهها برای آزمایش استفاده میکنیم و مابقی دادهها برای آموزش مدل استفاده خواهند شد.
train, test, train_labels, test_labels =
train_test_split(features,labels,test_size = 0.40, random_state = 42)
اکنون مدل را با دستورات زیر میسازیم −
from sklearn.naive_bayes import GaussianNBدستور بالا ماژول GaussianNB را فراخوانی میکند. اکنون با دستور دادهشده در زیر، باید مدل را مقداردهی اولیه کنیم.
gnb = GaussianNB()ما مدل را با برازش آن روی دادهها با استفاده از ()gnb.fit آموزش خواهیم داد.
model = gnb.fit(train, train_labels)اکنون مدل را با انجام پیشبینی روی دادههای آزمایشی ارزیابی کنید و این کار به صورت زیر انجام میشود −
preds = gnb.predict(test)
print(preds)

[1 0 0 1 1 0 0 0 1 1 1 0 1 0 1 0 1 1 1 0 1 1 0 1 1 1 1 1 1
 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1 1 0
 0 1 1 0 0 1 1 1 0 0 1 1 0 0 1 0 1 1 1 1 1 1 0 1 1 0 0 0 0
 0 1 1 1 1 1 1 1 1 0 0 1 0 0 1 0 0 1 1 1 0 1 1 0 1 1 0 0 0
 1 1 1 0 0 1 1 0 1 0 0 1 1 0 0 0 1 1 1 0 1 1 0 0 1 0 1 1 0
 1 0 0 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0
 1 1 0 1 1 1 1 1 1 0 0 0 1 1 0 1 0 1 1 1 1 0 1 1 0 1 1 1 0
 1 0 0 1 1 1 1 1 1 1 1 0 1 1 1 1 1 0 1 0 0 1 1 0 1]
سری بالا از اعداد ۰ و ۱، مقادیر پیشبینیشده برای کلاسهای تومور یعنی بدخیم و خوشخیم هستند.
اکنون با مقایسه دو آرایه یعنی test_labels و preds، میتوانیم دقت مدل خود را به دست آوریم. ما قصد داریم از تابع accuracy_score() برای تعیین دقت استفاده کنیم. دستور زیر را در نظر بگیرید −
from sklearn.metrics import accuracy_score
print(accuracy_score(test_labels,preds))
0.951754385965
نتیجه نشان میدهد که طبقهبند بیز ساده دارای دقت ۹۵.۱۷٪ است.
این یک طبقهبند یادگیری ماشین بر اساس مدل گاوسی بیز ساده بود.
ماشینهای بردار پشتیبان (SVM)
اساساً، ماشین بردار پشتیبان (SVM) یک الگوریتم یادگیری ماشین تحت نظارت است که میتواند برای هر دو موضوع رگرسیون و طبقهبندی استفاده شود. مفهوم اصلی SVM ترسیم هر آیتم داده به عنوان نقطهای در فضای n بعدی است، به طوری که مقدار هر ویژگی برابر با مقدار یک مختصات خاص باشد. در اینجا n تعداد ویژگیهایی است که خواهیم داشت. در ادامه یک نمایش گرافیکی ساده برای درک مفهوم SVM آورده شده است −
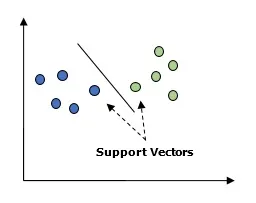
در نمودار بالا، ما دو ویژگی داریم. بنابراین ابتدا باید این دو متغیر را در فضای دو بعدی رسمی کنیم، جایی که هر نقطه دارای دو مختصات است که بردار پشتیبان نامیده میشوند. خط، دادهها را به دو گروه طبقهبندیشده مختلف تقسیم میکند. این خط همان طبقهبند خواهد بود.
در اینجا قصد داریم یک طبقهبند SVM با استفاده از scikit-learn و مجموعه داده iris بسازیم. کتابخانه Scikitlearn دارای ماژول sklearn.svm است و sklearn.svm.svc را برای طبقهبندی ارائه میدهد. طبقهبند SVM برای پیشبینی کلاس گیاه زنبق (iris) بر اساس ۴ ویژگی در زیر نشان داده شده است.
مجموعه داده
ما از مجموعه داده iris استفاده خواهیم کرد که شامل ۳ کلاس ۵۰ نمونهای است و هر کلاس به یک نوع گیاه زنبق اشاره دارد. هر نمونه دارای چهار ویژگی یعنی طول کاسبرگ، عرض کاسبرگ، طول گلبرگ و عرض گلبرگ است. طبقهبند SVM برای پیشبینی کلاس گیاه زنبق بر اساس ۴ ویژگی در زیر نشان داده شده است.
کرنل (Kernel)
این تکنیکی است که توسط SVM استفاده میشود. در واقع اینها توابعی هستند که فضای ورودی با ابعاد پایین را گرفته و آن را به فضایی با ابعاد بالاتر تبدیل میکنند. این تابع مسئله جدانشدنی را به مسئلهای جداپذیر تبدیل میکند. تابع کرنل میتواند هر یک از انواع خطی (linear)، چندجملهای (polynomial)، rbf و سیگموئید (sigmoid) باشد. در این مثال، از کرنل خطی استفاده خواهیم کرد.
کتابخانههای زیر را فراخوانی میکنیم −
import pandas as pd
import numpy as np
from sklearn import svm, datasets
import matplotlib.pyplot as plt
اکنون دادههای ورودی را بارگذاری کنید −
iris = datasets.load_iris()ما دو ویژگی اول را در نظر میگیریم −
X = iris.data[:, :2]
y = iris.target
مرزهای ماشین بردار پشتیبان را با دادههای اصلی رسم خواهیم کرد. در حال ایجاد یک مش (شبکه) برای رسم هستیم.
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
h = (x_max / x_min)/100
xx, yy = np.meshgrid(np.arange(x_min, x_max, h),
np.arange(y_min, y_max, h))
X_plot = np.c_[xx.ravel(), yy.ravel()]
باید مقدار پارامتر منظمسازی را مشخص کنیم.
C = 1.0باید شیء طبقهبند SVM را ایجاد کنیم.
Svc_classifier = svm_classifier.SVC(kernel='linear',
C=C, decision_function_shape = 'ovr').fit(X, y)
Z = svc_classifier.predict(X_plot)
Z = Z.reshape(xx.shape)
plt.figure(figsize = (15, 5))
plt.subplot(121)
plt.contourf(xx, yy, Z, cmap = plt.cm.tab10, alpha = 0.3)
plt.scatter(X[:, 0], X[:, 1], c = y, cmap = plt.cm.Set1)
plt.xlabel('Sepal length')
plt.ylabel('Sepal width')
plt.xlim(xx.min(), xx.max())
plt.title('SVC with linear kernel')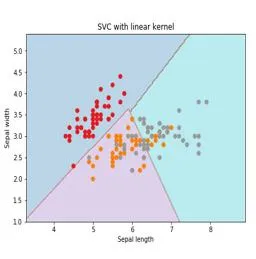
رگرسیون لوجستیک
اساساً مدل رگرسیون لوجستیک یکی از اعضای خانواده الگوریتمهای طبقهبندی تحت نظارت است. رگرسیون لوجستیک رابطه بین متغیرهای وابسته و متغیرهای مستقل را با برآورد احتمالها با استفاده از یک تابع لوجستیک اندازهگیری میکند.
در اینجا، اگر درباره متغیرهای وابسته و مستقل صحبت کنیم، متغیر وابسته همان متغیر کلاس هدف است که قصد پیشبینی آن را داریم و در طرف دیگر، متغیرهای مستقل ویژگیهایی هستند که قرار است از آنها برای پیشبینی کلاس هدف استفاده کنیم.
در رگرسیون لوجستیک، تخمین احتمالها به معنای پیشبینی احتمال وقوع یک رویداد است. برای مثال، مغازهدار میخواهد پیشبینی کند مشتری که وارد مغازه شده است (به عنوان مثال) پلیاستیشن خواهد خرید یا خیر. ویژگیهای زیادی از مشتری وجود خواهد داشت − جنسیت، سن و غیره که توسط مغازهدار برای پیشبینی احتمال وقوع، یعنی خرید پلیاستیشن یا عدم خرید آن، مشاهده میشود. تابع لوجستیک همان منحنی سیگموئید است که برای ساخت تابع با پارامترهای مختلف استفاده میشود.
پیشنیازها
قبل از ساخت طبقهبند با استفاده از رگرسیون لوجستیک، باید بسته Tkinter را روی سیستم خود نصب کنیم. این بسته از آدرس https://docs.python.org/2/library/tkinter.html قابل نصب است.
اکنون با کمک کد دادهشده در زیر، میتوانیم یک طبقهبند با استفاده از رگرسیون لوجستیک ایجاد کنیم −
ابتدا برخی از بستهها را فراخوانی میکنیم −
import numpy as np
from sklearn import linear_model
import matplotlib.pyplot as plt
اکنون باید دادههای نمونه را تعریف کنیم که به صورت زیر انجام میشود −
X = np.array([[2, 4.8], [2.9, 4.7], [2.5, 5], [3.2, 5.5], [6, 5], [7.6, 4],
              [3.2, 0.9], [2.9, 1.9],[2.4, 3.5], [0.5, 3.4], [1, 4], [0.9, 5.9]])
y = np.array([0, 0, 0, 1, 1, 1, 2, 2, 2, 3, 3, 3])
سپس باید طبقهبند رگرسیون لوجستیک را ایجاد کنیم که به صورت زیر انجام میشود −
Classifier_LR = linear_model.LogisticRegression(solver = 'liblinear', C = 75)در نهایت، باید این طبقهبند را آموزش دهیم −
Classifier_LR.fit(X, y)حال چگونه میتوانیم خروجی را بصریسازی کنیم؟ این کار با ایجاد تابعی به نام ()Logistic_visualize قابل انجام است −
Def Logistic_visualize(Classifier_LR, X, y):
   min_x, max_x = X[:, 0].min() - 1.0, X[:, 0].max() +
پیشرفت مطالعه: وضعیت خواندهشدن این درس فقط در همین مرورگر ذخیره میشود؛ بدون نیاز به حساب کاربری.