آموزش هوش مصنوعی با پایتون - تحلیل دادههای سری زمانی
پیشبینی مقدار بعدی در یک دنباله ورودی مشخص، یکی دیگر از مفاهیم مهم در یادگیری ماشین است. این فصل توضیحی مفصل درباره تحلیل دادههای سری زمانی به شما ارائه میدهد.
مقدمه
دادههای سری زمانی به دادههایی گفته میشود که در مجموعهای از بازههای زمانی مشخص قرار دارند. اگر بخواهیم در یادگیری ماشین مدلی برای پیشبینی دنبالهها بسازیم، باید با دادههای ترتیبی و زمان سروکار داشته باشیم. دادههای سری زمانی نوعی نمایش انتزاعی از دادههای ترتیبی هستند. ترتیب دادهها یکی از ویژگیهای مهم دادههای ترتیبی است.
مفهوم پایه تحلیل دنباله یا تحلیل سری زمانی
تحلیل دنباله یا تحلیل سری زمانی به معنای پیشبینی مقدار بعدی در یک دنباله ورودی مشخص، بر اساس مقادیر مشاهدهشده قبلی است. مقدار پیشبینیشده میتواند هر چیزی باشد که در ادامه میآید؛ مانند یک نماد، یک عدد، وضعیت آبوهوای روز بعد، واژه بعدی در گفتار و موارد دیگر. تحلیل دنباله میتواند در کاربردهایی مانند تحلیل بازار سهام، پیشبینی آبوهوا و پیشنهاد محصولات بسیار مفید باشد.
مثال
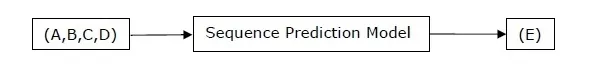
برای درک پیشبینی دنباله، مثال زیر را در نظر بگیرید. در اینجا مقادیر A,B,C,D داده شدهاند و باید با استفاده از یک مدل پیشبینی دنباله، مقدار E را پیشبینی کنید.
نصب بستههای کاربردی
برای تحلیل دادههای سری زمانی با استفاده از پایتون، باید بستههای زیر را نصب کنیم:
Pandas
Pandas یک کتابخانه متنباز با مجوز BSD است که ساختارهای داده با کارایی بالا، سهولت استفاده و ابزارهای تحلیل داده را برای پایتون فراهم میکند. میتوانید Pandas را با استفاده از دستور زیر نصب کنید:
pip install pandasاگر از Anaconda استفاده میکنید و میخواهید این بسته را با کمک مدیر بسته conda نصب کنید، میتوانید از دستور زیر استفاده کنید:
conda install -c anaconda pandashmmlearn
این کتابخانهای متنباز با مجوز BSD است که شامل الگوریتمها و مدلهای سادهای برای یادگیری مدلهای مارکوف پنهان (HMM) در پایتون میشود. میتوانید آن را با استفاده از دستور زیر نصب کنید:
pip install hmmlearnاگر از Anaconda استفاده میکنید و میخواهید این بسته را با کمک مدیر بسته conda نصب کنید، میتوانید از دستور زیر استفاده کنید:
conda install -c omnia hmmlearnPyStruct
این کتابخانهای برای یادگیری و پیشبینی ساختاریافته است. الگوریتمهای یادگیری پیادهسازیشده در PyStruct نامهایی مانند میدانهای تصادفی شرطی (CRF)، شبکههای تصادفی مارکوف با حاشیه بیشینه (M3N) یا ماشینهای بردار پشتیبان ساختاری دارند. میتوانید آن را با استفاده از دستور زیر نصب کنید:
pip install pystructCVXOPT
این بسته برای بهینهسازی محدب بر پایه زبان برنامهنویسی پایتون استفاده میشود. همچنین، یک بسته نرمافزاری رایگان است. میتوانید آن را با استفاده از دستور زیر نصب کنید:
pip install cvxoptاگر از Anaconda استفاده میکنید و میخواهید این بسته را با کمک مدیر بسته conda نصب کنید، میتوانید از دستور زیر استفاده کنید:
conda install -c anaconda cvdoxtPandas: مدیریت، برش و استخراج آمار از دادههای سری زمانی
اگر لازم باشد با دادههای سری زمانی کار کنید، Pandas ابزار بسیار مفیدی است. با کمک Pandas میتوانید کارهای زیر را انجام دهید:
-
با استفاده از بسته pd.date_range، محدودهای از تاریخها ایجاد کنید.
-
با استفاده از بسته pd.Series، دادههای Pandas را بر اساس تاریخها نمایهگذاری کنید.
-
با استفاده از بسته ts.resample، نمونهبرداری مجدد انجام دهید.
-
بسامد را تغییر دهید.
مثال
مثال زیر نحوه مدیریت و برش دادههای سری زمانی را با استفاده از Pandas نشان میدهد. توجه داشته باشید که در اینجا از دادههای ماهانه نوسان قطبی شمالگان استفاده میکنیم که میتوان آنها را از monthly.ao.index.b50.current.ascii دانلود کرد و برای استفاده در این مثال به قالب متنی تبدیل کرد.
مدیریت دادههای سری زمانی
برای مدیریت دادههای سری زمانی، باید مراحل زیر را انجام دهید:
در مرحله اول، بستههای زیر را وارد کنید:
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd
سپس، تابعی تعریف کنید که دادهها را از فایل ورودی بخواند؛ همانطور که در کد زیر نشان داده شده است:
def read_data(input_file):
   input_data = np.loadtxt(input_file, delimiter = None)
اکنون، این دادهها را به سری زمانی تبدیل کنید. برای این کار، محدوده تاریخهای سری زمانی خود را ایجاد کنید. در این مثال، بسامد دادهها را یک ماه در نظر میگیریم. فایل ما شامل دادههایی است که از ژانویه ۱۹۵۰ آغاز میشوند.
dates = pd.date_range('1950-01', periods = input_data.shape[0], freq = 'M')در این مرحله، با کمک سریهای Pandas دادههای سری زمانی را ایجاد میکنیم؛ همانطور که در ادامه نشان داده شده است:
output = pd.Series(input_data[:, index], index = dates)
return output

if __name__=='__main__':
مسیر فایل ورودی را به شکل زیر وارد کنید:
input_file = "/Users/admin/AO.txt"اکنون، ستون را به قالب سری زمانی تبدیل کنید؛ همانطور که در اینجا نشان داده شده است:
timeseries = read_data(input_file)در نهایت، با استفاده از دستورهای زیر دادهها را رسم و مشاهده کنید:
plt.figure()
timeseries.plot()
plt.show()
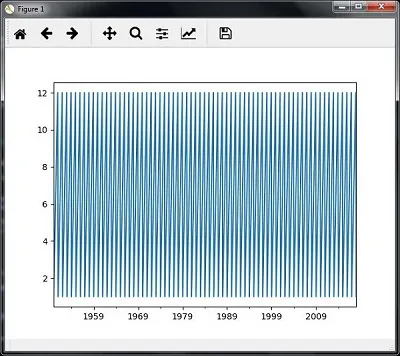
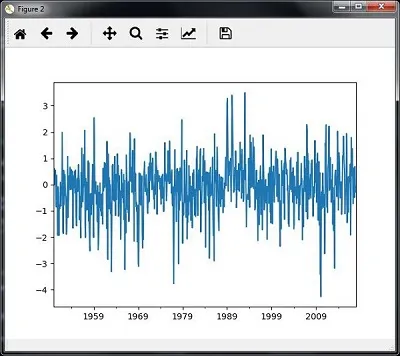
نمودارهایی مشابه تصاویر زیر مشاهده خواهید کرد:
برش دادههای سری زمانی
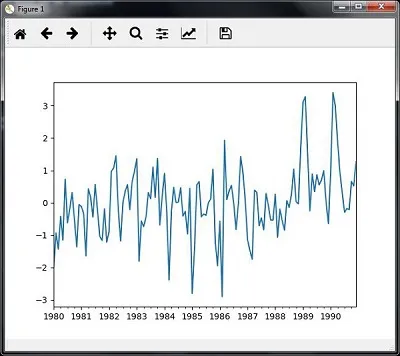
برش به معنای بازیابی تنها بخشی از دادههای سری زمانی است. در این مثال، دادهها را فقط از سال ۱۹۸۰ تا ۱۹۹۰ برش میدهیم. کد زیر را که این کار را انجام میدهد، مشاهده کنید:
timeseries['1980':'1990'].plot()
   <matplotlib.axes._subplots.AxesSubplot at 0xa0e4b00>

plt.show()
هنگامی که کد مربوط به برش دادههای سری زمانی را اجرا کنید، نمودار زیر را مطابق تصویر مشاهده خواهید کرد:
استخراج آمار از دادههای سری زمانی
در مواردی که لازم است به نتیجهگیریهای مهمی برسید، باید برخی آمارها را از دادههای موجود استخراج کنید. میانگین، واریانس، همبستگی، بیشینه و کمینه از جمله این آمارها هستند. اگر بخواهید چنین آمارهایی را از دادههای سری زمانی مشخصی استخراج کنید، میتوانید از کد زیر استفاده کنید:
میانگین
برای محاسبه میانگین، میتوانید از تابع mean() استفاده کنید؛ همانطور که در اینجا نشان داده شده است:
timeseries.mean()خروجیای که برای مثال مورد بحث مشاهده خواهید کرد، به این صورت است:
-0.11143128165238671بیشینه
برای یافتن بیشترین مقدار، میتوانید از تابع max() استفاده کنید؛ همانطور که در اینجا نشان داده شده است:
timeseries.max()خروجیای که برای مثال مورد بحث مشاهده خواهید کرد، به این صورت است:
3.4952999999999999کمینه
برای یافتن کمترین مقدار، میتوانید از تابع min() استفاده کنید؛ همانطور که در اینجا نشان داده شده است:
timeseries.min()خروجیای که برای مثال مورد بحث مشاهده خواهید کرد، به این صورت است:
-4.2656999999999998دریافت همه آمارها بهصورت یکجا
اگر میخواهید همه آمارها را بهطور همزمان محاسبه کنید، میتوانید از تابع describe() به شکل زیر استفاده کنید:
timeseries.describe()خروجیای که برای مثال مورد بحث مشاهده خواهید کرد، به این صورت است:
count   817.000000
mean     -0.111431
std       1.003151
min      -4.265700
25%      -0.649430
50%      -0.042744
75%       0.475720
max       3.495300
dtype: float64نمونهبرداری مجدد
میتوانید دادهها را با بسامد زمانی متفاوتی نمونهبرداری مجدد کنید. دو پارامتر مورد استفاده برای انجام نمونهبرداری مجدد عبارتاند از:
- بازه زمانی
- روش
نمونهبرداری مجدد با میانگین (mean())
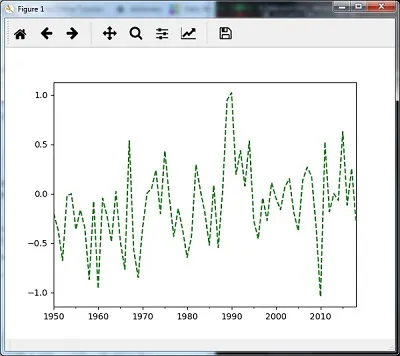
میتوانید از کد زیر برای نمونهبرداری مجدد دادهها با روش میانگین (mean()) استفاده کنید. این روش، روش پیشفرض است:
timeseries_mm = timeseries.resample("A").mean()
timeseries_mm.plot(style = 'g--')
plt.show()
در ادامه، نمودار زیر را بهعنوان خروجی نمونهبرداری مجدد با استفاده از میانگین (mean()) مشاهده خواهید کرد:
نمونهبرداری مجدد با میانه (median())
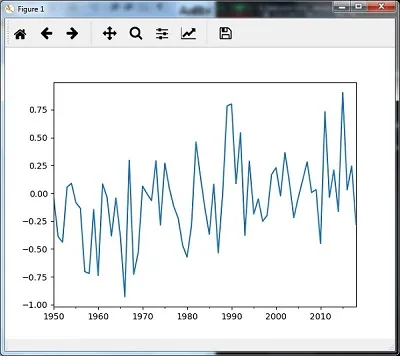
میتوانید از کد زیر برای نمونهبرداری مجدد دادهها با استفاده از روش median() استفاده کنید:
timeseries_mm = timeseries.resample("A").median()
timeseries_mm.plot()
plt.show()
در ادامه، نمودار زیر را بهعنوان خروجی نمونهبرداری مجدد با استفاده از میانه (median()) مشاهده خواهید کرد:
میانگین متحرک
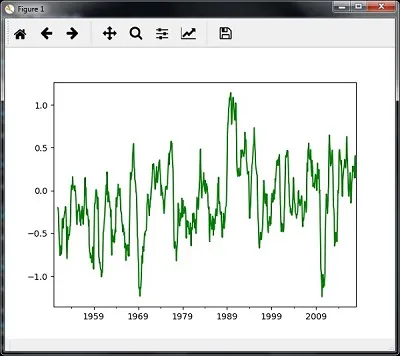
میتوانید از کد زیر برای محاسبه میانگین متحرک استفاده کنید:
timeseries.rolling(window = 12, center = False).mean().plot(style = '-g')
plt.show()
در ادامه، نمودار زیر را بهعنوان خروجی میانگین متحرک مشاهده خواهید کرد:
تحلیل دادههای ترتیبی با استفاده از مدل مارکوف پنهان (HMM)
مدل مارکوف پنهان (HMM) یک مدل آماری است که بهطور گسترده برای دادههایی با پیوستگی و قابلیت گسترش، مانند دادههای سری زمانی در تحلیل بازار سهام، بررسی وضعیت سلامت و تشخیص گفتار، استفاده میشود. این بخش به بررسی دقیق تحلیل دادههای ترتیبی با استفاده از مدل مارکوف پنهان (HMM) میپردازد.
مدل مارکوف پنهان (HMM)
مدل مارکوف پنهان (HMM) یک مدل تصادفی است که بر اساس مفهوم زنجیره مارکوف ساخته شده و این فرض را در نظر میگیرد که احتمال وضعیتهای آینده فقط به وضعیت فعلی فرایند وابسته است، نه به هیچیک از وضعیتهای پیشین آن. برای مثال، هنگام پرتاب سکه نمیتوانیم بگوییم که نتیجه پرتاب پنجم حتماً شیر خواهد بود. دلیل این موضوع آن است که سکه حافظهای ندارد و نتیجه بعدی به نتیجه قبلی وابسته نیست.
از نظر ریاضی، مدل مارکوف پنهان از متغیرهای زیر تشکیل شده است:
حالتها (S)
مجموعهای از حالتهای پنهان یا نهفته موجود در مدل مارکوف پنهان است که با S نشان داده میشود.
نمادهای خروجی (O)
مجموعهای از نمادهای خروجی ممکن در مدل مارکوف پنهان است که با O نشان داده میشود.
ماتریس احتمال انتقال حالت (A)
احتمال انتقال از یک حالت به هر یک از حالتهای دیگر است که با A نشان داده میشود.
ماتریس احتمال انتشار مشاهدات (B)
احتمال انتشار یا مشاهده یک نماد در یک حالت مشخص است که با B نشان داده میشود.
ماتریس احتمال پیشین ()
احتمال شروع از یک حالت مشخص، در میان حالتهای مختلف سیستم است که با نماد نشان داده میشود.
بنابراین، مدل مارکوف پنهان را میتوان بهصورت = (S,O,A,B,) تعریف کرد،
که در آن:
- S = {s1,s2,,sN} مجموعهای از N حالت ممکن است،
- O = {o1,o2,,oM} مجموعهای از M نماد مشاهده ممکن است،
- A یک ماتریس احتمال انتقال حالت (TPM) با ابعاد NN است،
- B یک ماتریس احتمال مشاهده یا انتشار (EPM) با ابعاد NM است،
- یک بردار توزیع احتمال حالت اولیه با N بُعد است.
مثال: تحلیل دادههای بازار سهام
در این مثال، دادههای بازار سهام را گامبهگام تحلیل میکنیم تا با نحوه عملکرد مدل مارکوف پنهان (HMM) روی دادههای ترتیبی یا سری زمانی آشنا شویم. لطفاً توجه داشته باشید که این مثال را با استفاده از پایتون پیادهسازی میکنیم.
بستههای موردنیاز را مطابق کد زیر وارد کنید:
import datetime
import warnings
اکنون، از دادههای بازار سهام موجود در بسته matpotlib.finance به شکل زیر استفاده کنید:
import numpy as np
from matplotlib import cm, pyplot as plt
from matplotlib.dates import YearLocator, MonthLocator
try:
   from matplotlib.finance import quotes_historical_yahoo_och1
except ImportError:
   from matplotlib.finance import (
      quotes_historical_yahoo as quotes_historical_yahoo_och1)

from hmmlearn.hmm import GaussianHMMدادهها را از یک تاریخ شروع تا یک تاریخ پایان، یعنی بین دو تاریخ مشخص، مطابق کد زیر بارگذاری کنید:
start_date = datetime.date(1995, 10, 10)
end_date = datetime.date(2015, 4, 25)
quotes = quotes_historical_yahoo_och1('INTC', start_date, end_date)
در این مرحله، قیمت پایانی سهام را برای هر روز استخراج میکنیم. برای این کار، از دستور زیر استفاده کنید:
closing_quotes = np.array([quote[2] for quote in quotes])اکنون، حجم سهام معاملهشده در هر روز را استخراج میکنیم. برای این کار، از دستور زیر استفاده کنید:
volumes = np.array([quote[5] for quote in quotes])[1:]در اینجا، درصد تغییرات قیمت پایانی سهام را با استفاده از کد زیر محاسبه کنید:
diff_percentages = 100.0 * np.diff(closing_quotes) / closing_quotes[:-]
dates = np.array([quote[0] for quote in quotes], dtype = np.int)[1:]
training_data = np.column_stack([diff_percentages, volumes])
در این مرحله، مدل مارکوف پنهان گاوسی (Gaussian HMM) را ایجاد و آموزش دهید. برای این کار، از کد زیر استفاده کنید:
hmm = GaussianHMM(n_components = 7, covariance_type = 'diag', n_iter = 1000)
with warnings.catch_warnings():
   warnings.simplefilter('ignore')
   hmm.fit(training_data)
اکنون، با استفاده از مدل HMM و دستورهای زیر داده تولید کنید:
num_samples = 300
samples, _ = hmm.sample(num_samples)
در نهایت، در این مرحله، درصد تغییرات قیمت و حجم سهام معاملهشده را بهصورت نمودار رسم و مشاهده میکنیم.
برای رسم و مشاهده درصد تغییرات، از کد زیر استفاده کنید:
plt.figure()
plt.title('Difference percentages')
plt.plot(np.arange(num_samples), samples[:, 0], c = 'black')
برای رسم و مشاهده حجم سهام معاملهشده، از کد زیر استفاده کنید:
plt.figure()
plt.title('Volume of shares')
plt.plot(np.arange(num_samples), samples[:, 1], c = 'black')
plt.ylim(ymin = 0)
plt.show()
پیشرفت مطالعه: وضعیت خواندهشدن این درس فقط در همین مرورگر ذخیره میشود؛ بدون نیاز به حساب کاربری.