آموزش هوش مصنوعی با پایتون - تشخیص گفتار
در این فصل، با استفاده از هوش مصنوعی و پایتون، با تشخیص گفتار آشنا خواهیم شد.
گفتار ابتداییترین وسیله ارتباطی انسان بالغ است. هدف اصلی پردازش گفتار، برقراری تعامل میان انسان و ماشین است.
سیستم پردازش گفتار عمدتاً سه وظیفه دارد:
-
اول، تشخیص گفتار که به ماشین امکان میدهد کلمات، عبارتها و جملههایی را که بیان میکنیم، دریافت و تشخیص دهد.
-
دوم، پردازش زبان طبیعی که به ماشین امکان میدهد منظور ما از گفتارمان را درک کند؛ و
-
سوم، سنتز گفتار که به ماشین امکان میدهد صحبت کند.
این فصل بر تشخیص گفتار تمرکز دارد؛ فرایندی که طی آن کلمات بیانشده توسط انسان درک میشوند. به خاطر داشته باشید که سیگنالهای گفتاری با کمک میکروفون دریافت میشوند و سپس سیستم باید آنها را درک کند.
ساخت یک سیستم تشخیص گفتار
تشخیص گفتار یا تشخیص خودکار گفتار (ASR)، یکی از محورهای اصلی توجه در پروژههای هوش مصنوعی مانند رباتیک است. بدون ASR، تصور یک ربات شناختی که با انسان تعامل داشته باشد، امکانپذیر نیست. بااینحال، ساخت یک سیستم تشخیص گفتار کار چندان آسانی نیست.
دشواریهای توسعه سیستم تشخیص گفتار
توسعه یک سیستم تشخیص گفتار باکیفیت واقعاً مسئله دشواری است. دشواری فناوری تشخیص گفتار را میتوان بهطور کلی بر اساس چندین بُعد بررسی کرد که در ادامه توضیح داده شدهاند:
-
اندازه واژگان - اندازه واژگان بر میزان دشواری توسعه یک سیستم ASR تأثیر میگذارد. برای درک بهتر، اندازههای مختلف واژگان زیر را در نظر بگیرید.
-
واژگان کوچک شامل ۲ تا ۱۰۰ کلمه است؛ برای مثال، واژگان مورد استفاده در یک سیستم منوی صوتی.
-
واژگان متوسط شامل چند صد تا چند هزار کلمه است؛ برای مثال، واژگان مورد استفاده در یک وظیفه بازیابی اطلاعات از پایگاه داده.
-
واژگان بزرگ شامل چند ده هزار کلمه است؛ مانند واژگانی که در یک وظیفه دیکته عمومی استفاده میشوند.
توجه داشته باشید که هرچه اندازه واژگان بزرگتر باشد، انجام تشخیص دشوارتر خواهد بود.
-
ویژگیهای کانال - کیفیت کانال نیز یکی از ابعاد مهم است. برای مثال، گفتار انسان دارای پهنای باند زیاد و محدوده فرکانسی کامل است، درحالیکه گفتار تلفنی پهنای باند کمتری دارد و محدوده فرکانسی آن محدود است. توجه داشته باشید که تشخیص گفتار در حالت دوم دشوارتر است.
-
حالت صحبت کردن - سهولت توسعه یک سیستم ASR به حالت صحبت کردن نیز بستگی دارد؛ یعنی اینکه گفتار بهصورت کلمات مجزا، کلمات پیوسته یا گفتار پیوسته ارائه شود. توجه داشته باشید که تشخیص گفتار پیوسته دشوارتر است.
-
سبک صحبت کردن - گفتار خواندهشده ممکن است سبکی رسمی داشته باشد یا بهصورت خودجوش و محاورهای و با لحنی غیررسمی بیان شود. تشخیص حالت دوم دشوارتر است.
-
وابستگی به گوینده - سیستم تشخیص گفتار میتواند وابسته به گوینده، سازگارشونده با گوینده یا مستقل از گوینده باشد. ساخت سیستمی که مستقل از گوینده عمل کند، دشوارترین حالت است.
-
نوع نویز - هنگام توسعه یک سیستم ASR، نویز نیز عامل دیگری است که باید در نظر گرفته شود. نسبت سیگنال به نویز ممکن است در محدودههای مختلفی قرار بگیرد که به محیط صوتی و میزان کم یا زیاد بودن نویز پسزمینه بستگی دارد:
-
اگر نسبت سیگنال به نویز بیشتر از 30dB باشد، در محدوده بالا در نظر گرفته میشود.
-
اگر نسبت سیگنال به نویز بین 30dB تا 10db باشد، نسبت سیگنال به نویز متوسط در نظر گرفته میشود.
-
اگر نسبت سیگنال به نویز کمتر از 10dB باشد، در محدوده پایین قرار میگیرد.
برای مثال، نوع نویز پسزمینه، مانند نویز ثابت، نویز غیرانسانی، گفتار پسزمینه و تداخل گفتار گویندگان دیگر، نیز بر دشواری مسئله تأثیر میگذارد.
-
ویژگیهای میکروفون - کیفیت میکروفون ممکن است خوب، متوسط یا پایینتر از حد متوسط باشد. همچنین فاصله بین دهان و میکروفون میتواند متفاوت باشد. این عوامل نیز باید در سیستمهای تشخیص گفتار در نظر گرفته شوند.
با وجود این دشواریها، پژوهشگران تلاشهای زیادی برای بررسی جنبههای مختلف گفتار انجام دادهاند؛ از جمله درک سیگنال گفتار، شناسایی گوینده و تشخیص لهجهها.
برای ساخت یک سیستم تشخیص گفتار، باید مراحل زیر را دنبال کنید:
بصریسازی سیگنالهای صوتی - خواندن از فایل و کار با آن
این نخستین گام در ساخت یک سیستم تشخیص گفتار است، زیرا درک بهتری از ساختار سیگنال صوتی فراهم میکند. برخی از مراحل رایج کار با سیگنالهای صوتی عبارتاند از:
ضبط
اگر میخواهید سیگنال صوتی را از یک فایل بخوانید، ابتدا آن را با استفاده از میکروفون ضبط کنید.
نمونهبرداری
هنگام ضبط با میکروفون، سیگنالها بهصورت دیجیتالی ذخیره میشوند. اما برای پردازش آنها، ماشین به مقادیر عددی گسسته نیاز دارد. بنابراین، باید با یک فرکانس مشخص نمونهبرداری انجام دهیم و سیگنال را به شکل عددی گسسته تبدیل کنیم. انتخاب فرکانس نمونهبرداری بالا باعث میشود که انسان هنگام شنیدن سیگنال، آن را بهصورت یک سیگنال صوتی پیوسته احساس کند.
مثال
مثال زیر روشی مرحلهبهمرحله برای تحلیل یک سیگنال صوتی ذخیرهشده در فایل با استفاده از پایتون نشان میدهد. فرکانس نمونهبرداری این سیگنال صوتی 44,100 هرتز است.
بستههای موردنیاز را مطابق زیر وارد کنید:
import numpy as np
import matplotlib.pyplot as plt
from scipy.io import wavfile
اکنون فایل صوتی ذخیرهشده را بخوانید. این دستور دو مقدار برمیگرداند: فرکانس نمونهبرداری و سیگنال صوتی. مسیر فایل صوتی ذخیرهشده را مطابق زیر وارد کنید:
frequency_sampling, audio_signal = wavfile.read("/Users/admin/audio_file.wav")پارامترهایی مانند فرکانس نمونهبرداری سیگنال صوتی، نوع داده سیگنال و مدتزمان آن را با استفاده از دستورهای زیر نمایش دهید:
print('\nSignal shape:', audio_signal.shape)
print('Signal Datatype:', audio_signal.dtype)
print('Signal duration:', round(audio_signal.shape[0] /
float(frequency_sampling), 2), 'seconds')
در این مرحله، سیگنال را مطابق زیر نرمالسازی میکنیم:
audio_signal = audio_signal / np.power(2, 15)در این مرحله، برای بصریسازی، ۱۰۰ مقدار نخست این سیگنال را استخراج میکنیم. برای این کار از دستورهای زیر استفاده کنید:
audio_signal = audio_signal [:100]
time_axis = 1000 * np.arange(0, len(signal), 1) / float(frequency_sampling)
اکنون با استفاده از دستورهای زیر، سیگنال را بصریسازی کنید:
plt.plot(time_axis, signal, color='blue')
plt.xlabel('Time (milliseconds)')
plt.ylabel('Amplitude')
plt.title('Input audio signal')
plt.show()میتوانید نمودار خروجی و دادههای استخراجشده از سیگنال صوتی بالا را مطابق تصویر زیر مشاهده کنید.
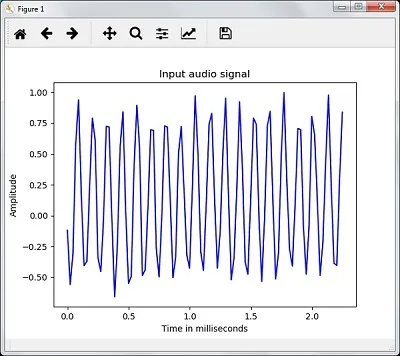
Signal shape: (132300,)
Signal Datatype: int16
Signal duration: 3.0 secondsمشخصهیابی سیگنال صوتی: تبدیل به حوزه فرکانس
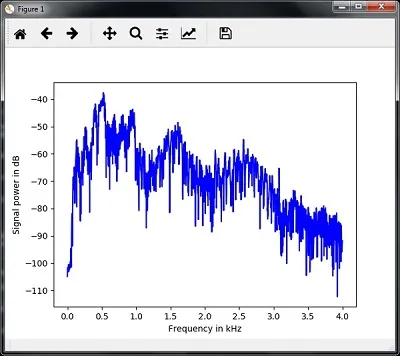
مشخصهیابی یک سیگنال صوتی شامل تبدیل سیگنال از حوزه زمان به حوزه فرکانس و درک مؤلفههای فرکانسی آن است. این مرحله اهمیت زیادی دارد، زیرا اطلاعات فراوانی درباره سیگنال فراهم میکند. برای انجام این تبدیل میتوانید از یک ابزار ریاضی مانند تبدیل فوریه استفاده کنید.
مثال
مثال زیر بهصورت مرحلهبهمرحله نشان میدهد که چگونه میتوان سیگنال ذخیرهشده در یک فایل را با استفاده از پایتون مشخصهیابی کرد. توجه داشته باشید که در اینجا برای تبدیل سیگنال به حوزه فرکانس از ابزار ریاضی تبدیل فوریه استفاده میکنیم.
بستههای موردنیاز را مطابق زیر وارد کنید:
import numpy as np
import matplotlib.pyplot as plt
from scipy.io import wavfile
اکنون فایل صوتی ذخیرهشده را بخوانید. این دستور دو مقدار برمیگرداند: فرکانس نمونهبرداری و سیگنال صوتی. مسیر فایل صوتی ذخیرهشده را مطابق دستور زیر وارد کنید:
frequency_sampling, audio_signal = wavfile.read("/Users/admin/sample.wav")در این مرحله، پارامترهایی مانند فرکانس نمونهبرداری سیگنال صوتی، نوع داده سیگنال و مدتزمان آن را با استفاده از دستورهای زیر نمایش میدهیم:
print('\nSignal shape:', audio_signal.shape)
print('Signal Datatype:', audio_signal.dtype)
print('Signal duration:', round(audio_signal.shape[0] /
float(frequency_sampling), 2), 'seconds')
در این مرحله، باید سیگنال را مطابق دستور زیر نرمالسازی کنیم:
audio_signal = audio_signal / np.power(2, 15)این مرحله شامل استخراج طول سیگنال و نصف طول آن است. برای این کار از دستورهای زیر استفاده کنید:
length_signal = len(audio_signal)
half_length = np.ceil((length_signal + 1) / 2.0).astype(np.int)
اکنون باید از ابزارهای ریاضی برای تبدیل سیگنال به حوزه فرکانس استفاده کنیم. در اینجا از تبدیل فوریه استفاده میکنیم.
signal_frequency = np.fft.fft(audio_signal)اکنون سیگنال حوزه فرکانس را نرمالسازی کرده و مقادیر آن را به توان دو برسانید:
signal_frequency = abs(signal_frequency[0:half_length]) / length_signal
signal_frequency **= 2
در مرحله بعد، طول و نصف طول سیگنال تبدیلشده به حوزه فرکانس را استخراج کنید:
len_fts = len(signal_frequency)توجه داشته باشید که سیگنال تبدیلشده با تبدیل فوریه باید برای هر دو حالت طول زوج و طول فرد تنظیم شود.
if length_signal % 2:
   signal_frequency[1:len_fts] *= 2
else:
   signal_frequency[1:len_fts-1] *= 2
اکنون توان سیگنال را برحسب دسیبل (dB) استخراج کنید:
signal_power = 10 * np.log10(signal_frequency)فرکانس را برای محور X برحسب کیلوهرتز تنظیم کنید:
x_axis = np.arange(0, len_half, 1) * (frequency_sampling / length_signal) / 1000.0اکنون مشخصههای سیگنال را بهصورت زیر بصریسازی کنید:
plt.figure()
plt.plot(x_axis, signal_power, color='black')
plt.xlabel('Frequency (kHz)')
plt.ylabel('Signal power (dB)')
plt.show()میتوانید نمودار خروجی کد بالا را مطابق تصویر زیر مشاهده کنید:
تولید سیگنال صوتی تکفرکانسی
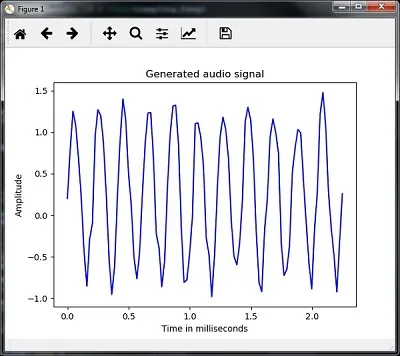
دو مرحلهای که تاکنون مشاهده کردید، برای یادگیری درباره سیگنالها اهمیت دارند. این مرحله زمانی مفید است که بخواهید سیگنال صوتی را با برخی پارامترهای از پیش تعیینشده تولید کنید. توجه داشته باشید که در این مرحله، سیگنال صوتی در یک فایل خروجی ذخیره میشود.
مثال
در مثال زیر، با استفاده از پایتون یک سیگنال تکفرکانسی تولید میکنیم که در یک فایل ذخیره خواهد شد. برای این کار باید مراحل زیر را دنبال کنید:
بستههای موردنیاز را مطابق زیر وارد کنید:
import numpy as np
import matplotlib.pyplot as plt
from scipy.io.wavfile import write
مسیر فایلی را مشخص کنید که فایل خروجی باید در آن ذخیره شود.
output_file = 'audio_signal_generated.wav'اکنون پارامترهای دلخواه خود را مطابق زیر مشخص کنید:
duration = 4 # in seconds
frequency_sampling = 44100 # in Hz
frequency_tone = 784
min_val = -4 * np.pi
max_val = 4 * np.pi
در این مرحله، میتوانیم سیگنال صوتی را مطابق زیر تولید کنیم:
t = np.linspace(min_val, max_val, duration * frequency_sampling)
audio_signal = np.sin(2 * np.pi * tone_freq * t)
اکنون فایل صوتی را در فایل خروجی ذخیره کنید:
write(output_file, frequency_sampling, signal_scaled)۱۰۰ مقدار نخست را برای رسم نمودار مطابق زیر استخراج کنید:
audio_signal = audio_signal[:100]
time_axis = 1000 * np.arange(0, len(signal), 1) / float(sampling_freq)
اکنون سیگنال صوتی تولیدشده را بهصورت زیر بصریسازی کنید:
plt.plot(time_axis, signal, color='blue')
plt.xlabel('Time in milliseconds')
plt.ylabel('Amplitude')
plt.title('Generated audio signal')
plt.show()میتوانید نمودار را مطابق شکل زیر مشاهده کنید:
استخراج ویژگی از گفتار
این مهمترین مرحله در ساخت یک سیستم تشخیص گفتار است، زیرا پس از تبدیل سیگنال گفتار به حوزه فرکانس، باید آن را به شکل قابل استفادهای از بردار ویژگی تبدیل کنیم. برای این منظور میتوانیم از روشهای مختلف استخراج ویژگی مانند MFCC، PLP و PLP-RASTA استفاده کنیم.
مثال
در مثال زیر، با استفاده از پایتون و روش MFCC، ویژگیهای سیگنال را بهصورت مرحلهبهمرحله استخراج میکنیم.
بستههای موردنیاز را مطابق زیر وارد کنید:
import numpy as np
import matplotlib.pyplot as plt
from scipy.io import wavfile
from python_speech_features import mfcc, logfbank
اکنون فایل صوتی ذخیرهشده را بخوانید. این دستور دو مقدار برمیگرداند: فرکانس نمونهبرداری و سیگنال صوتی. مسیر فایل صوتی ذخیرهشده را وارد کنید.
frequency_sampling, audio_signal = wavfile.read("/Users/admin/audio_file.wav")توجه داشته باشید که در اینجا برای تحلیل، ۱۵۰۰۰ نمونه نخست را انتخاب میکنیم.
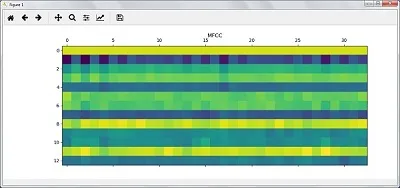
audio_signal = audio_signal[:15000]از روش MFCC استفاده کنید و دستور زیر را برای استخراج ویژگیهای MFCC اجرا کنید:
features_mfcc = mfcc(audio_signal, frequency_sampling)اکنون پارامترهای MFCC را مطابق زیر چاپ کنید:
print('\nMFCC:\nNumber of windows =', features_mfcc.shape[0])
print('Length of each feature =', features_mfcc.shape[1])
اکنون ویژگیهای MFCC را با استفاده از دستورهای زیر رسم و بصریسازی کنید:
features_mfcc = features_mfcc.T
plt.matshow(features_mfcc)
plt.title('MFCC')
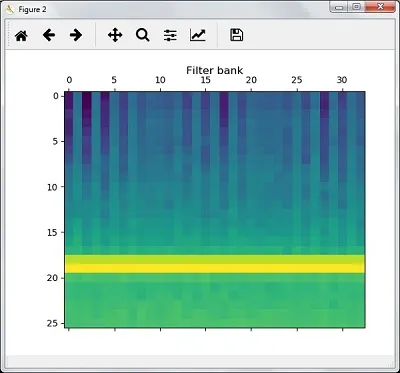
در این مرحله، مطابق زیر با ویژگیهای بانک فیلتر کار میکنیم:
ویژگیهای بانک فیلتر را استخراج کنید:
filterbank_features = logfbank(audio_signal, frequency_sampling)اکنون پارامترهای بانک فیلتر را چاپ کنید.
print('\nFilter bank:\nNumber of windows =', filterbank_features.shape[0])
print('Length of each feature =', filterbank_features.shape[1])
اکنون ویژگیهای بانک فیلتر را رسم و بصریسازی کنید.
filterbank_features = filterbank_features.T
plt.matshow(filterbank_features)
plt.title('Filter bank')
plt.show()
در نتیجه مراحل بالا، میتوانید خروجیهای زیر را مشاهده کنید: شکل ۱ مربوط به MFCC و شکل ۲ مربوط به بانک فیلتر است.
تشخیص کلمات گفتاری
تشخیص گفتار به این معناست که ماشین هنگام صحبت کردن انسان، گفتار او را درک کند. در اینجا برای انجام این کار از رابط برنامهنویسی گفتار گوگل (Google Speech API) در پایتون استفاده میکنیم. برای این منظور باید بستههای زیر را نصب کنیم:
-
Pyaudio - این بسته را میتوان با استفاده از دستور pip install Pyaudio نصب کرد.
-
SpeechRecognition - این بسته را میتوان با استفاده از دستور pip install SpeechRecognition. نصب کرد.
-
Google-Speech-API - این بسته را میتوان با استفاده از دستور pip install google-api-python-client نصب کرد.
مثال
برای آشنایی با تشخیص کلمات گفتاری، مثال زیر را بررسی کنید:
بستههای موردنیاز را مطابق زیر وارد کنید:
import speech_recognition as srمطابق زیر یک شیء ایجاد کنید:
recording = sr.Recognizer()اکنون ماژول Microphone() صدا را بهعنوان ورودی دریافت میکند:
with sr.Microphone() as source: recording.adjust_for_ambient_noise(source)
   print("Please Say something:")
   audio = recording.listen(source)
اکنون رابط برنامهنویسی گوگل صدا را تشخیص میدهد و نتیجه را ارائه میکند.
try:
   print("You said: \n" + recording.recognize_google(audio))
except Exception as e:
   print(e)
خروجی زیر را مشاهده خواهید کرد:
Please Say Something:
You said:
برای مثال، اگر عبارت tutorialspoint.com را بیان کنید، سیستم آن را بهدرستی و به شکل زیر تشخیص میدهد:
tutorialspoint.comپیشرفت مطالعه: وضعیت خواندهشدن این درس فقط در همین مرورگر ذخیره میشود؛ بدون نیاز به حساب کاربری.