آموزش هوش مصنوعی با پایتون - یادگیری ماشین
یادگیری به معنای کسب دانش یا مهارت از طریق مطالعه یا تجربه است. بر همین اساس، میتوانیم یادگیری ماشین (ML) را به صورت زیر تعریف کنیم −
یادگیری ماشین را میتوان حوزهای از علوم کامپیوتر، و به طور دقیقتر کاربردی از هوش مصنوعی تعریف کرد که به سیستمهای کامپیوتر این امکان را میدهد تا با استفاده از دادهها یاد بگیرند و از طریق تجربه بهبود یابند، بدون اینکه به صورت صریح برنامهنویسی شده باشند.
در واقع، تمرکز اصلی یادگیری ماشین این است که به کامپیوترها اجازه دهد به طور خودکار و بدون دخالت انسان یاد بگیرند. حال این سوال مطرح میشود که چنین یادگیری چگونه آغاز میشود و انجام میگیرد؟ این فرایند میتواند با مشاهده دادهها آغاز شود. این دادهها میتوانند شامل مثالها، دستورالعملها یا تجربیات مستقیم باشند. سپس بر اساس این ورودی، ماشین با جستجوی الگوها در دادهها، تصمیمات بهتری میگیرد.
انواع یادگیری ماشین (ML)
الگوریتمهای یادگیری ماشین به سیستم کامپیوتری کمک میکنند تا بدون برنامهنویسی صریح یاد بگیرد. این الگوریتمها به دو دسته نظارتشده (Supervised) و نظارتنشده (Unsupervised) تقسیم میشوند. در ادامه به بررسی چند الگوریتم میپردازیم −
الگوریتمهای یادگیری ماشین نظارتشده
این دسته، پرکاربردترین الگوریتمهای یادگیری ماشین هستند. دلیل نامگذاری آن به عنوان «نظارتشده» این است که فرایند یادگیری الگوریتم از مجموعه دادههای آموزشی را میتوان مانند معلمی تصور کرد که بر فرایند یادگیری نظارت دارد. در این نوع از الگوریتمهای یادگیری ماشین، نتایج ممکن از قبل مشخص هستند و دادههای آموزشی نیز با پاسخهای درست برچسبگذاری شدهاند. این موضوع را میتوان به صورت زیر درک کرد −
فرض کنید متغیرهای ورودی x و یک متغیر خروجی y داریم و الگوریتمی را برای یادگیری تابع نگاشت از ورودی به خروجی اعمال کردهایم، مانند −
Y = f(x)اکنون، هدف اصلی این است که تابع نگاشت را آنقدر خوب تقریب بزنیم که وقتی دادههای ورودی جدیدی (x) داریم، بتوانیم متغیر خروجی (Y) را برای آن دادهها پیشبینی کنیم.
مسائل یادگیری نظارتشده عمدتاً به دو نوع زیر تقسیم میشوند −
-
طبقه بندی (Classification) − زمانی یک مسئله، مسئله طبقهبندی نامیده میشود که خروجی دستهبندیشده داشته باشیم؛ مانند مشکی، آموزشی، غیرآموزشی و غیره.
-
رگرسیون (Regression) − زمانی یک مسئله، مسئله رگرسیون نامیده میشود که خروجی با مقدار واقعی (پیوسته) داشته باشیم؛ مانند مسافت، کیلوگرم و غیره.
درخت تصمیم (Decision Tree)، جنگل تصادفی (Random Forest)، K-نزدیکترین همسایه (KNN) و رگرسیون لوجستیک (Logistic Regression) از نمونههای الگوریتمهای یادگیری ماشین نظارتشده هستند.
الگوریتمهای یادگیری ماشین نظارتنشده
همانطور که از نام آن پیداست، این نوع الگوریتمهای یادگیری ماشین هیچ ناظری برای ارائه راهنمایی ندارند. به همین دلیل است که الگوریتمهای یادگیری ماشین نظارتنشده با آنچه برخی هوش مصنوعی واقعی مینامند همراستایی نزدیکی دارند. این موضوع را میتوان به صورت زیر درک کرد −
فرض کنید متغیر ورودی x را داریم، در این صورت برخلاف الگوریتمهای یادگیری نظارتشده، هیچ متغیر خروجی متناظری وجود نخواهد داشت.
به زبان ساده، میتوان گفت در یادگیری نظارتنشده هیچ پاسخ درستی وجود ندارد و معلمی برای راهنمایی نیست. الگوریتمها به کشف الگوهای جالب در دادهها کمک میکنند.
مسائل یادگیری نظارتنشده را میتوان به دو نوع مسئله زیر تقسیم کرد −
-
خوشهبندی (Clustering) − در مسائل خوشهبندی، باید گروهبندیهای ذاتی موجود در دادهها را کشف کنیم. به عنوان مثال، گروهبندی مشتریان بر اساس رفتار خرید آنها.
-
انجمن یا وابستگی (Association) − یک مسئله از این رو مسئله وابستگی نامیده میشود که نیازمند کشف قواعدی است که بخشهای بزرگی از دادههای ما را توصیف میکنند. به عنوان مثال، یافتن مشتریانی که هر دو محصول x و y را میخرند.
الگوریتم K-means برای خوشهبندی و الگوریتم Apriori برای وابستگی، نمونههایی از الگوریتمهای یادگیری ماشین نظارتنشده هستند.
الگوریتمهای یادگیری ماشین تقویتی
این نوع الگوریتمهای یادگیری ماشین کمتر مورد استفاده قرار میگیرند. این الگوریتمها سیستمها را طوری آموزش میدهند که تصمیمات خاصی بگیرند. در واقع، ماشین در معرض محیطی قرار میگیرد که در آن با استفاده از روش آزمون و خطا به طور مداوم خود را آموزش میدهد. این الگوریتمها از تجربیات گذشته یاد میگیرند و سعی میکنند بهترین دانش ممکن را برای اخذ تصمیمات دقیق به دست آورند. فرآیند تصمیمگیری مارکوف (Markov Decision Process) نمونهای از الگوریتمهای یادگیری ماشین تقویتی است.
رایجترین الگوریتمهای یادگیری ماشین
در این بخش با رایجترین الگوریتمهای یادگیری ماشین آشنا میشویم. الگوریتمها در ادامه توصیف شدهاند −
رگرسیون خطی (Linear Regression)
این الگوریتم یکی از شناختهشدهترین الگوریتمها در آمار و یادگیری ماشین است.
مفهوم پایه − رگرسیون خطی عمدتاً یک مدل خطی است که رابطه خطی بین متغیرهای ورودی (مثلاً x) و تک متغیر خروجی (مثلاً y) را فرض میکند. به عبارت دیگر، میتوان گفت y از ترکیب خطی متغیرهای ورودی x قابل محاسبه است. رابطه بین متغیرها را میتوان با برازش بهترین خط برقرار کرد.
انواع رگرسیون خطی
رگرسیون خطی به دو نوع زیر است −
-
رگرسیون خطی ساده − یک الگوریتم رگرسیون خطی اگر تنها دارای یک متغیر مستقل باشد، رگرسیون خطی ساده نامیده میشود.
-
رگرسیون خطی چندگانه − یک الگوریتم رگرسیون خطی اگر دارای بیش از یک متغیر مستقل باشد، رگرسیون خطی چندگانه نامیده میشود.
رگرسیون خطی عمدتاً برای برآورد مقادیر واقعی بر اساس متغیر(های) پیوسته استفاده میشود. به عنوان مثال، فروش کل یک فروشگاه در یک روز را میتوان بر اساس مقادیر واقعی با استفاده از رگرسیون خطی برآورد کرد.
رگرسیون لوجستیک (Logistic Regression)
این یک الگوریتم طبقهبندی است و به عنوان رگرسیون لوجیت (logit) نیز شناخته میشود.
رگرسیون لوجستیک عمدتاً یک الگوریتم طبقهبندی است که برای برآورد مقادیر گسسته مانند ۰ یا ۱، درست یا نادرست، بله یا خیر بر اساس مجموعهای از متغیرهای مستقل استفاده میشود. در واقع، این الگوریتم احتمال را پیشبینی میکند، بنابراین خروجی آن بین ۰ و ۱ قرار دارد.
درخت تصمیم (Decision Tree)
درخت تصمیم یک الگوریتم یادگیری نظارتشده است که بیشتر برای مسائل طبقهبندی استفاده میشود.
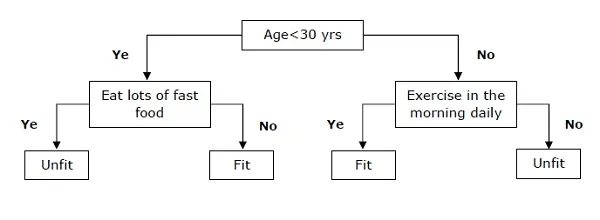
در واقع، این یک طبقهبندیکننده است که به صورت افراز بازگشتی بر اساس متغیرهای مستقل بیان میشود. درخت تصمیم دارای گرههایی است که یک درخت ریشهدار را تشکیل میدهند. درخت ریشهدار یک درخت جهتدار با گرهای به نام ریشه است. ریشه هیچ یال ورودی ندارد و تمام گرههای دیگر دارای یک یال ورودی هستند. به این گرهها برگ یا گرههای تصمیم گفته میشود. به عنوان مثال، درخت تصمیم زیر را برای بررسی اینکه آیا یک فرد آماده/تندرست است یا خیر در نظر بگیرید.
ماشین بردار پشتیبان (SVM)
این الگوریتم هم برای مسائل طبقهبندی و هم برای مسائل رگرسیون استفاده میشود، اما بیشتر کاربرد آن در مسائل طبقهبندی است. مفهوم اصلی SVM این است که هر داده را به عنوان نقطهای در یک فضای n بعدی رسم کند، به طوری که مقدار هر ویژگی برابر با مقدار یک مختصات خاص باشد. در اینجا n تعداد ویژگیهایی است که داریم. در ادامه یک نمایش گرافیکی ساده برای درک مفهوم SVM آمده است −
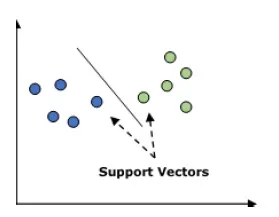
در نمودار بالا، دو ویژگی داریم، بنابراین ابتدا باید این دو متغیر را در یک فضای دوبعدی رسم کنیم که هر نقطه دارای دو مختصات است که بردارهای پشتیبان نامیده میشوند. خط موجود، دادهها را به دو گروه مختلف طبقهبندیشده تقسیم میکند. این خط همان طبقهبندیکننده خواهد بود.
نایو بیز (Naive Bayes)
این روش نیز یک تکنیک طبقهبندی است. منطق پشت این تکنیک طبقهبندی، استفاده از قضیه بیز برای ساخت طبقهبندیکنندهها است. فرض بر این است که پیشبینیکنندهها مستقل هستند. به زبان ساده، فرض میکند که وجود یک ویژگی خاص در یک کلاس به وجود هر ویژگی دیگری نامربوط است. در زیر معادله قضیه بیز آمده است −
$$P\left ( \frac{A}{B} \right ) = \frac{P\left ( \frac{B}{A} \right )P\left ( A \right )}{P\left ( B \right )}$$
ساخت مدل نایو بیز آسان است و بهویژه برای مجموعهدادههای بزرگ بسیار مفید است.
K-نزدیکترین همسایه (KNN)
این الگوریتم هم برای طبقهبندی و هم برای رگرسیون مسائل استفاده میشود و به طور گسترده برای حل مسائل طبقهبندی به کار میرود. مفهوم اصلی این الگوریتم این است که تمام موارد موجود را ذخیره میکند و موارد جدید را بر اساس اکثریت آرای k همسایه آن طبقهبندی میکند. سپس مورد جدید به کلاسی اختصاص مییابد که در میان K نزدیکترین همسایهاش رایجترین است و این فاصله توسط یک تابع فاصله اندازهگیری میشود. تابع فاصله میتواند فاصله اقلیدسی، مینکوفسکی و همینگ باشد. موارد زیر را برای استفاده از KNN در نظر بگیرید −
-
از نظر محاسباتی، KNN نسبت به سایر الگوریتمهای مورد استفاده برای مسائل طبقهبندی سنگینتر و پرهزینهتر است.
-
نرمالسازی متغیرها مورد نیاز است، در غیر این صورت متغیرهای با دامنه بزرگتر میتوانند باعث تورش و انحراف شوند.
-
در KNN، لازم است روی مرحله پیشپردازش مانند حذف نویز کار کنیم.
خوشهبندی K-Means
همانطور که از نامش پیداست، برای حل مسائل خوشهبندی استفاده میشود. این روش در واقع نوعی یادگیری نظارتنشده است. منطق اصلی الگوریتم خوشهبندی K-Means طبقهبندی مجموعه دادهها از طریق تعدادی خوشه است. برای تشکیل خوشهها با K-means این مراحل را دنبال کنید −
-
الگوریتم K-means تعداد k نقطه را برای هر خوشه انتخاب میکند که به عنوان مرکزوار (Centroid) شناخته میشوند.
-
اکنون هر نقطه داده با نزدیکترین مرکزوارها یک خوشه تشکیل میدهد، یعنی k خوشه.
-
سپس، مرکزوار جدید هر خوشه را بر اساس اعضای موجود در آن خوشه پیدا میکند.
-
باید این مراحل را تا زمانی که همگرایی رخ دهد تکرار کنیم.
جنگل تصادفی (Random Forest)
این یک الگوریتم طبقهبندی نظارتشده است. مزیت الگوریتم جنگل تصادفی این است که هم برای مسائل طبقهبندی و هم برای مسائل رگرسیون قابل استفاده است. در واقع این الگوریتم مجموعهای از درختان تصمیم (یعنی جنگل) است یا به عبارتی میتوان گفت یک انسامبل (Ensemble) از درختان تصمیم است. مفهوم پایه جنگل تصادفی این است که هر درخت یک طبقهبندی ارائه میدهد و جنگل بهترین طبقهبندیها را از بین آنها انتخاب میکند. مزایای الگوریتم جنگل تصادفی به شرح زیر است −
-
طبقهبندیکننده جنگل تصادفی هم برای وظایف طبقهبندی و هم برای رگرسیون قابل استفاده است.
-
این الگوریتم میتواند مقادیر مفقود (Missing values) را مدیریت کند.
-
حتی اگر تعداد درختان بیشتری در جنگل داشته باشیم، مدل دچار بیشبرازش (Overfitting) نخواهد شد.
پیشرفت مطالعه: وضعیت خواندهشدن این درس فقط در همین مرورگر ذخیره میشود؛ بدون نیاز به حساب کاربری.