آموزش هوش مصنوعی با پایتون - بسته NLTK
در این فصل، یاد میگیریم چگونه کار با بسته ابزار پردازش زبان طبیعی (NLTK) را آغاز کنیم.
پیشنیاز
اگر بخواهیم برنامههایی مبتنی بر پردازش زبان طبیعی بسازیم، تغییر زمینه و بافت زبانی یکی از دشوارترین چالشها خواهد بود. عامل بافت بر نحوه درک یک جمله خاص توسط ماشین تأثیر میگذارد. بنابراین، باید برنامههای پردازش زبان طبیعی را با استفاده از روشهای یادگیری ماشین توسعه دهیم تا ماشین نیز بتواند بافت زبانی را همانطور که انسان درک میکند، درک کند.
برای ساخت چنین برنامههایی، از بسته پایتون به نام NLTK (بسته ابزار پردازش زبان طبیعی) استفاده خواهیم کرد.
وارد کردن NLTK
پیش از استفاده از NLTK، باید آن را نصب کنیم. این بسته را میتوان با استفاده از دستور زیر نصب کرد:
pip install nltkبرای ساخت یک بسته Conda برای NLTK، از دستور زیر استفاده کنید:
conda install -c anaconda nltkپس از نصب بسته NLTK، باید آن را از طریق محیط خط فرمان پایتون وارد کنیم. برای این کار، دستور زیر را در محیط خط فرمان پایتون مینویسیم:
>>> import nltkدانلود دادههای NLTK
پس از وارد کردن NLTK، باید دادههای موردنیاز را دانلود کنیم. این کار را میتوان با اجرای دستور زیر در محیط خط فرمان پایتون انجام داد:
>>> nltk.download()نصب بستههای ضروری دیگر
برای ساخت برنامههای پردازش زبان طبیعی با استفاده از NLTK، باید بستههای ضروری را نصب کنیم. این بستهها عبارتاند از:
gensim
این بسته یک کتابخانه قدرتمند برای مدلسازی معنایی است که در بسیاری از برنامهها کاربرد دارد. میتوانیم آن را با اجرای دستور زیر نصب کنیم:
pip install gensimpattern
از این بسته برای عملکرد صحیح بسته gensim استفاده میشود. میتوانیم آن را با اجرای دستور زیر نصب کنیم.
pip install patternمفهوم توکنسازی، ریشهیابی و لماتیزهکردن
در این بخش، با مفاهیم توکنسازی، ریشهیابی و لماتیزهکردن آشنا خواهیم شد.
توکنسازی
توکنسازی را میتوان فرایند شکستن متن دادهشده، یعنی دنبالهای از نویسهها، به واحدهای کوچکتری به نام توکن تعریف کرد. توکنها میتوانند کلمهها، اعداد یا علائم نگارشی باشند. به این فرایند قطعهبندی کلمات نیز گفته میشود. در ادامه، یک مثال ساده از توکنسازی آورده شده است:
ورودی − انبه، موز، آناناس و سیب، همگی میوه هستند.
خروجی − 
فرایند شکستن متن دادهشده را میتوان با شناسایی مرزهای کلمات انجام داد. به نقطه پایان یک کلمه و نقطه آغاز کلمه جدید، مرز کلمه گفته میشود. نظام نوشتاری و ساختار حروفچینی کلمات بر این مرزها تأثیر میگذارند.
در ماژول NLTK پایتون، بستههای مختلفی مرتبط با توکنسازی وجود دارند که میتوانیم از آنها برای تقسیم متن به توکنها، متناسب با نیازهای خود، استفاده کنیم. برخی از این بستهها عبارتاند از:
بسته sent_tokenize
همانطور که از نام آن مشخص است، این بسته متن ورودی را به جملهها تقسیم میکند. میتوانیم این بسته را با استفاده از کد پایتون زیر وارد کنیم:
from nltk.tokenize import sent_tokenizeبسته word_tokenize
این بسته متن ورودی را به کلمات تقسیم میکند. میتوانیم این بسته را با استفاده از کد پایتون زیر وارد کنیم:
from nltk.tokenize import word_tokenizeبسته WordPunctTokenizer
این بسته متن ورودی را هم به کلمات و هم به علائم نگارشی تقسیم میکند. میتوانیم این بسته را با استفاده از کد پایتون زیر وارد کنیم:
from nltk.tokenize import WordPuncttokenizerریشهیابی
هنگام کار با کلمات، به دلایل دستوری با شکلهای گوناگونی از آنها روبهرو میشویم. منظور از این تفاوتها، شکلهای مختلف یک کلمه با ریشه یکسان است؛ مانند democracy, democratic, و democratization. بسیار ضروری است که ماشینها بتوانند درک کنند این کلمات متفاوت، شکل پایه یکسانی دارند. به این ترتیب، استخراج شکل پایه کلمات هنگام تحلیل متن مفید خواهد بود.
میتوانیم با استفاده از ریشهیابی به این هدف دست پیدا کنیم. بنابراین، ریشهیابی را میتوان فرایند ابتکاری استخراج شکل پایه کلمات از طریق حذف انتهای آنها دانست.
در ماژول NLTK پایتون، بستههای مختلفی برای ریشهیابی وجود دارند. از این بستهها میتوان برای بهدستآوردن شکل پایه کلمات استفاده کرد. این بستهها از الگوریتمها بهره میبرند. برخی از آنها عبارتاند از:
بسته PorterStemmer
این بسته پایتون برای استخراج شکل پایه کلمات از الگوریتم پورتر استفاده میکند. میتوانیم این بسته را با استفاده از کد پایتون زیر وارد کنیم:
from nltk.stem.porter import PorterStemmerبرای مثال، اگر کلمه writing را بهعنوان ورودی به این ریشهیاب بدهیم، پس از ریشهیابی کلمه write را دریافت خواهیم کرد.
بسته LancasterStemmer
این بسته پایتون برای استخراج شکل پایه کلمات از الگوریتم لنکستر استفاده میکند. میتوانیم این بسته را با استفاده از کد پایتون زیر وارد کنیم:
from nltk.stem.lancaster import LancasterStemmerبرای مثال، اگر کلمه writing را بهعنوان ورودی به این ریشهیاب بدهیم، پس از ریشهیابی کلمه write را دریافت خواهیم کرد.
بسته SnowballStemmer
این بسته پایتون برای استخراج شکل پایه کلمات از الگوریتم اسنوبال استفاده میکند. میتوانیم این بسته را با استفاده از کد پایتون زیر وارد کنیم:
from nltk.stem.snowball import SnowballStemmerبرای مثال، اگر کلمه writing را بهعنوان ورودی به این ریشهیاب بدهیم، پس از ریشهیابی کلمه write را دریافت خواهیم کرد.
تمام این الگوریتمها از نظر میزان سختگیری با یکدیگر تفاوت دارند. اگر این سه ریشهیاب را با هم مقایسه کنیم، ریشهیاب پورتر کمترین سختگیری و ریشهیاب لنکستر بیشترین سختگیری را دارد. ریشهیاب اسنوبال از نظر سرعت و میزان سختگیری گزینه مناسبی برای استفاده است.
لماتیزهکردن
با استفاده از لماتیزهکردن نیز میتوانیم شکل پایه کلمات را استخراج کنیم. این فرایند اساساً با استفاده از واژگان و تحلیل صرفی کلمات انجام میشود و معمولاً هدف آن حذف پسوندهای صرفی است. شکل پایهای که به این روش برای یک کلمه به دست میآید، لِم نامیده میشود.
تفاوت اصلی ریشهیابی و لماتیزهکردن در استفاده از واژگان و تحلیل صرفی کلمات است. تفاوت دیگر این است که ریشهیابی معمولاً کلمات مرتبط از نظر اشتقاقی را به یک شکل مشترک تبدیل میکند، درحالیکه لماتیزهکردن معمولاً فقط شکلهای صرفی متفاوت یک لِم را به یکدیگر تبدیل میکند. برای مثال، اگر کلمه saw را بهعنوان ورودی ارائه کنیم، ریشهیابی ممکن است کلمه s را برگرداند؛ اما لماتیزهکردن تلاش میکند بسته به اینکه این توکن بهعنوان فعل یا اسم استفاده شده باشد، کلمه see یا saw را برگرداند.
در ماژول NLTK پایتون، بسته زیر برای فرایند لماتیزهکردن وجود دارد که میتوانیم از آن برای بهدستآوردن شکل پایه کلمات استفاده کنیم:
بسته WordNetLemmatizer
این بسته پایتون شکل پایه کلمه را بر اساس این موضوع استخراج میکند که کلمه بهعنوان اسم استفاده شده است یا فعل. میتوانیم این بسته را با استفاده از کد پایتون زیر وارد کنیم:
from nltk.stem import WordNetLemmatizerقطعهبندی: تقسیم دادهها به قطعات
قطعهبندی یکی از فرایندهای مهم در پردازش زبان طبیعی است. وظیفه اصلی آن شناسایی نقشهای دستوری و عبارتهای کوتاهی مانند گروههای اسمی است. پیشتر فرایند توکنسازی، یعنی ایجاد توکنها، را بررسی کردهایم. قطعهبندی اساساً به معنای برچسبگذاری این توکنهاست. به عبارت دیگر، قطعهبندی ساختار جمله را به ما نشان میدهد.
در بخش بعدی، با انواع مختلف قطعهبندی آشنا خواهیم شد.
انواع قطعهبندی
قطعهبندی دو نوع دارد که عبارتاند از:
حرکت از جزئیات به کلیات
در این فرایند قطعهبندی، اشیا، موارد و غیره به سمت مفاهیم کلیتر حرکت میکنند و زبان انتزاعیتر میشود. احتمال توافق بیشتر است. در این فرایند، دید خود را گستردهتر میکنیم. برای مثال، اگر این پرسش را که خودروها برای چه هدفی استفاده میشوند، به سطح کلیتری ببریم، ممکن است به پاسخ «حملونقل» برسیم.
حرکت از کلیات به جزئیات
در این فرایند قطعهبندی، اشیا، موارد و غیره به سمت مفاهیم مشخصتر حرکت میکنند و زبان جزئیات بیشتری پیدا میکند. در این روش، ساختار عمیقتر بررسی میشود. در این فرایند، روی جزئیات تمرکز میکنیم. برای مثال، اگر این پرسش را که «درباره یک خودرو بهطور مشخص توضیح بده» به سطح جزئیتری ببریم، اطلاعات دقیقتر و کوچکتری درباره خودرو به دست خواهیم آورد.
مثال
در این مثال، با استفاده از ماژول NLTK در پایتون، قطعهبندی گروه اسمی را انجام میدهیم. گروه اسمی یکی از دستههای قطعهبندی است که قطعات مربوط به گروههای اسمی را در جمله پیدا میکند.
برای پیادهسازی قطعهبندی گروه اسمی در پایتون، مراحل زیر را دنبال کنید:
مرحله ۱ − در این مرحله، باید دستور زبان مربوط به قطعهبندی را تعریف کنیم. این دستور زبان شامل قوانینی است که باید از آنها پیروی کنیم.
مرحله ۲ − در این مرحله، باید یک تجزیهگر قطعهبندی ایجاد کنیم. این تجزیهگر دستور زبان را تجزیه میکند و خروجی را ارائه میدهد.
مرحله ۳ − در این مرحله پایانی، خروجی در قالب یک درخت تولید میشود.
ابتدا بسته ضروری NLTK را به شکل زیر وارد میکنیم:
import nltkاکنون باید جمله را تعریف کنیم. در اینجا، DT به معنای حرف تعریفکننده، VBP به معنای فعل، JJ به معنای صفت، IN به معنای حرف اضافه و NN به معنای اسم است.
sentence=[("a","DT"),("clever","JJ"),("fox","NN"),("was","VBP"),
          ("jumping","VBP"),("over","IN"),("the","DT"),("wall","NN")]
اکنون باید دستور زبان را مشخص کنیم. در اینجا، دستور زبان را به شکل یک عبارت منظم ارائه میدهیم.
grammar = "NP:{<DT>?<JJ>*<NN>}"باید تجزیهگری تعریف کنیم که دستور زبان را تجزیه کند.
parser_chunking = nltk.RegexpParser(grammar)تجزیهگر، جمله را به شکل زیر تجزیه میکند:
parser_chunking.parse(sentence)در مرحله بعد، باید خروجی را دریافت کنیم. خروجی در متغیر سادهای به نام output_chunk ذخیره میشود.
Output_chunk = parser_chunking.parse(sentence)با اجرای کد زیر، میتوانیم خروجی خود را به شکل یک درخت رسم کنیم.
output.draw()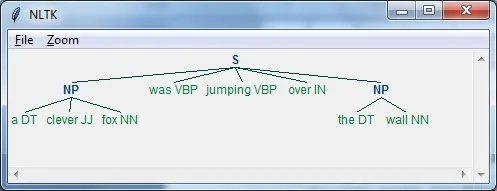
مدل کیسه کلمات (BoW)
مدل کیسه کلمات (BoW) در پردازش زبان طبیعی، اساساً برای استخراج ویژگیها از متن استفاده میشود تا بتوان از متن در مدلسازی، مانند الگوریتمهای یادگیری ماشین، بهره برد.
اکنون این پرسش مطرح میشود که چرا باید ویژگیها را از متن استخراج کنیم. دلیل آن این است که الگوریتمهای یادگیری ماشین نمیتوانند مستقیماً با دادههای خام کار کنند و به دادههای عددی نیاز دارند تا بتوانند اطلاعات معناداری از آنها استخراج کنند. تبدیل دادههای متنی به دادههای عددی، استخراج ویژگی یا کدگذاری ویژگی نامیده میشود.
نحوه عملکرد
این روش برای استخراج ویژگیها از متن بسیار ساده است. فرض کنید یک سند متنی داریم و میخواهیم آن را به دادههای عددی تبدیل کنیم یا ویژگیهای آن را استخراج کنیم. در این صورت، ابتدا این مدل واژگانی از تمام کلمات موجود در سند استخراج میکند. سپس با استفاده از ماتریس واژه و سند، مدلی میسازد. به این ترتیب، مدل BoW سند را صرفاً بهصورت کیسهای از کلمات نمایش میدهد. هرگونه اطلاعات مربوط به ترتیب یا ساختار کلمات در سند کنار گذاشته میشود.
مفهوم ماتریس واژه و سند
الگوریتم BoW با استفاده از ماتریس واژه و سند یک مدل میسازد. همانطور که از نام آن مشخص است، ماتریس واژه و سند ماتریسی از تعداد دفعات وقوع کلمات مختلف در سند است. با کمک این ماتریس، سند متنی را میتوان بهصورت ترکیبی وزندار از کلمات مختلف نمایش داد. با تعیین آستانه و انتخاب کلمات معنادارتر، میتوانیم نموداری از فراوانی تمام کلمات موجود در اسناد بسازیم که بهعنوان بردار ویژگی قابل استفاده است. در ادامه، مثالی برای درک مفهوم ماتریس واژه و سند ارائه شده است:
مثال
فرض کنید دو جمله زیر را داریم:
-
جمله ۱ − ما از مدل کیسه کلمات استفاده میکنیم.
-
جمله ۲ − مدل کیسه کلمات برای استخراج ویژگیها استفاده میشود.
اکنون با در نظر گرفتن این دو جمله، ۱۳ کلمه متمایز زیر را داریم:
- we
- are
- using
- the
- bag
- of
- words
- model
- is
- used
- for
- extracting
- features
اکنون باید با استفاده از تعداد دفعات وقوع هر کلمه در هر جمله، یک هیستوگرام برای هر جمله بسازیم:
-
جمله ۱ − [1,1,1,1,1,1,1,1,0,0,0,0,0]
-
جمله ۲ − [0,0,0,1,1,1,1,1,1,1,1,1,1]
به این ترتیب، بردارهای ویژگی استخراجشده را در اختیار داریم. هر بردار ویژگی ۱۳ بُعد دارد، زیرا ۱۳ کلمه متمایز داریم.
مفهوم آمار
این مفهوم با عنوان فراوانی واژه - فراوانی معکوس سند (tf-idf) شناخته میشود. هر کلمه در سند اهمیت دارد. آمار به ما کمک میکند اهمیت هر کلمه را درک کنیم.
فراوانی واژه (tf)
این معیار نشان میدهد هر کلمه با چه بسامدی در یک سند ظاهر میشود. برای محاسبه آن، تعداد دفعات وقوع هر کلمه را بر تعداد کل کلمات موجود در سند موردنظر تقسیم میکنیم.
فراوانی معکوس سند (idf)
این معیار نشان میدهد که یک کلمه در مجموعهای از اسناد، تا چه اندازه برای سند موردنظر منحصربهفرد است. برای محاسبه idf و ساخت یک بردار ویژگی متمایز، باید وزن کلمات پرتکرار مانند the را کاهش دهیم و وزن کلمات نادر را افزایش دهیم.
ساخت مدل کیسه کلمات در NLTK
در این بخش، با استفاده از CountVectorizer مجموعهای از رشتهها را تعریف میکنیم تا از این جملهها بردارهایی ایجاد کنیم.
ابتدا بسته موردنیاز را وارد میکنیم:
from sklearn.feature_extraction.text import CountVectorizerاکنون مجموعه جملهها را تعریف میکنیم.
Sentences = ['We are using the Bag of Word model', 'Bag of Word model is
           used for extracting the features.']

vectorizer_count = CountVectorizer()

features_text = vectorizer.fit_transform(Sentences).todense()

print(vectorizer.vocabulary_)
برنامه بالا خروجی زیر را تولید میکند. این خروجی نشان میدهد که در دو جمله بالا، ۱۳ کلمه متمایز وجود دارد:
{'we': 11, 'are': 0, 'using': 10, 'the': 8, 'bag': 1, 'of': 7,
'word': 12, 'model': 6, 'is': 5, 'used': 9, 'for': 4, 'extracting': 2, 'features': 3}اینها بردارهای ویژگی هستند که متن را به شکل عددی تبدیل میکنند و میتوان از آنها در یادگیری ماشین استفاده کرد.
حل مسائل
در این بخش، چند مسئله مرتبط را حل خواهیم کرد.
پیشبینی دستهبندی
در مجموعهای از اسناد، نهتنها کلمات، بلکه دستهبندی آنها نیز اهمیت دارد؛ یعنی اینکه یک کلمه خاص در کدام دسته از متون قرار میگیرد. برای مثال، میخواهیم پیشبینی کنیم که آیا یک جمله مشخص به دسته ایمیل، اخبار، ورزش، رایانه و غیره تعلق دارد یا خیر. در مثال زیر، از tf-idf برای ساخت یک بردار ویژگی استفاده میکنیم تا دستهبندی اسناد را مشخص کنیم. برای این کار، از دادههای مجموعه 20 newsgroups در scikit-learn استفاده خواهیم کرد.
باید بستههای موردنیاز را وارد کنیم:
from sklearn.datasets import fetch_20newsgroups
from sklearn.naive_bayes import MultinomialNB
from sklearn.feature_extraction.text import TfidfTransformer
from sklearn.feature_extraction.text import CountVectorizer
نگاشت دستهبندیها را تعریف میکنیم. از پنج دسته مختلف با نامهای دین، خودروها، ورزش، الکترونیک و فضا استفاده میکنیم.
category_map = {'talk.religion.misc':'Religion','rec.autos''Autos',
   'rec.sport.hockey':'Hockey','sci.electronics':'Electronics', 'sci.space': 'Space'}
مجموعه داده آموزشی را ایجاد میکنیم:
training_data = fetch_20newsgroups(subset = 'train',
   categories = category_map.keys(), shuffle = True, random_state = 5)
یک بردارساز شمارشی میسازیم و تعداد وقوع واژهها را استخراج میکنیم:
vectorizer_count = CountVectorizer()
train_tc = vectorizer_count.fit_transform(training_data.data)
print("\nDimensions of training data:", train_tc.shape)تبدیلگر tf-idf را به شکل زیر ایجاد میکنیم:
tfidf = TfidfTransformer()
train_tfidf = tfidf.fit_transform(train_tc)
اکنون دادههای آزمایشی را تعریف میکنیم:
input_data = [
   'Discovery was a space shuttle',
   'Hindu, Christian, Sikh all are religions',
   'We must have to drive safely',
   'Puck is a disk made of rubber',
   'Television, Microwave, Refrigrated all uses electricity'
]دادههای بالا به ما کمک میکنند یک دستهبند بیز ساده چندجملهای را آموزش دهیم:
classifier = MultinomialNB().fit(train_tfidf, training_data.target)دادههای ورودی را با استفاده از بردارساز شمارشی تبدیل میکنیم:
input_tc = vectorizer_count.transform(input_data)اکنون دادههای بردارسازیشده را با استفاده از تبدیلگر tf-idf تبدیل میکنیم:
input_tfidf = tfidf.transform(input_tc)دستههای خروجی را پیشبینی میکنیم:
predictions = classifier.predict(input_tfidf)خروجی به شکل زیر تولید میشود:
for sent, category in zip(input_data, predictions):
   print('\nInput Data:', sent, '\n Category:', \
category_map[training_data.target_names[category]])دستهبند، خروجی زیر را تولید میکند:
Dimensions of training data: (2755, 39297)

Input Data: Discovery was a space shuttle
Category: Space

Input Data: Hindu, Christian, Sikh all are religions
Category: Religion

Input Data: We must have to drive safely
Category: Autos

Input Data: Puck is a disk made of rubber
Category: Hockey

Input Data: Television, Microwave, Refrigrated all uses electricity
Category: Electronics
تشخیص جنسیت
در این مسئله، یک دستهبند آموزش داده میشود تا با دریافت نام افراد، جنسیت آنها را مشخص کند؛ یعنی مرد یا زن بودن آنها را تشخیص دهد. باید از یک روش ابتکاری برای ساخت بردار ویژگی و آموزش دستهبند استفاده کنیم. در این مثال، از دادههای برچسبگذاریشده موجود در بسته scikit-learn استفاده خواهیم کرد. در ادامه، کد پایتون برای ساخت یک تشخیصدهنده جنسیت آمده است:
ابتدا بستههای موردنیاز را وارد میکنیم:
import random

from nltk import NaiveBayesClassifier
from nltk.classify import accuracy as nltk_accuracy
from nltk.corpus import names
اکنون باید N حرف آخر کلمه ورودی را استخراج کنیم. این حروف بهعنوان ویژگی عمل خواهند کرد:
def extract_features(word, N = 2):
   last_n_letters = word[-N:]
   return {'feature': last_n_letters.lower()}

if __name__=='__main__':دادههای آموزشی را با استفاده از نامهای برچسبگذاریشده موجود در NLTK ایجاد میکنیم؛ این نامها شامل نامهای مردان و زنان هستند.
male_list = [(name, 'male') for name in names.words('male.txt')]
female_list = [(name, 'female') for name in names.words('female.txt')]
data = (male_list + female_list)

random.seed(5)
random.shuffle(data)
اکنون دادههای آزمایشی را به شکل زیر ایجاد میکنیم:
namesInput = ['Rajesh', 'Gaurav', 'Swati', 'Shubha']تعداد نمونههای مورد استفاده برای آموزش و آزمایش را با کد زیر مشخص میکنیم.
train_sample = int(0.8 * len(data))اکنون باید طولهای مختلف را بررسی کنیم تا بتوانیم دقت آنها را با یکدیگر مقایسه کنیم:
for i in range(1, 6):
   print('\nNumber of end letters:', i)
   features = [(extract_features(n, i), gender) for (n, gender) in data]
   train_data, test_data = features[:train_sample],
features[train_sample:]
   classifier = NaiveBayesClassifier.train(train_data)
دقت دستهبند را میتوان به شکل زیر محاسبه کرد:
accuracy_classifier = round(100 * nltk_accuracy(classifier, test_data), 2)
   print('Accuracy = ' + str(accuracy_classifier) + '%')
اکنون میتوانیم خروجی را پیشبینی کنیم:
for name in namesInput:
   print(name, '==>', classifier.classify(extract_features(name, i)))
برنامه بالا خروجی زیر را تولید میکند:
Number of end letters: 1
Accuracy = 74.7%
Rajesh -> female
Gaurav -> male
Swati -> female
Shubha -> female

Number of end letters: 2
Accuracy = 78.79%
Rajesh -> male
Gaurav -> male
Swati -> female
Shubha -> female

Number of end letters: 3
Accuracy = 77.22%
Rajesh -> male
Gaurav -> female
Swati -> female
Shubha -> female

Number of end letters: 4
Accuracy = 69.98%
Rajesh -> female
Gaurav -> female
Swati -> female
Shubha -> female

Number of end letters: 5
Accuracy = 64.63%
Rajesh -> female
Gaurav -> female
Swati -> female
Shubha -> female
در خروجی بالا میبینیم که بیشترین دقت زمانی به دست میآید که تعداد حروف انتهایی برابر با دو باشد. با افزایش تعداد حروف انتهایی، دقت کاهش مییابد.
مدلسازی موضوعی: شناسایی الگوها در دادههای متنی
میدانیم که اسناد معمولاً بر اساس موضوع دستهبندی میشوند. گاهی لازم است الگوهایی را در متن شناسایی کنیم که با موضوع خاصی ارتباط دارند. به تکنیک انجام این کار مدلسازی موضوعی گفته میشود. به عبارت دیگر، مدلسازی موضوعی روشی برای کشف موضوعات انتزاعی یا ساختارهای پنهان در مجموعهای از اسناد است.
میتوانیم از تکنیک مدلسازی موضوعی در موقعیتهای زیر استفاده کنیم:
دستهبندی متن
با کمک مدلسازی موضوعی میتوان دستهبندی را بهبود داد، زیرا این روش کلمات مشابه را در گروههای مشترک قرار میدهد، بهجای آنکه هر کلمه را بهصورت جداگانه بهعنوان یک ویژگی در نظر بگیرد.
سیستمهای پیشنهاددهنده
با کمک مدلسازی موضوعی، میتوانیم با استفاده از معیارهای شباهت، سیستمهای پیشنهاددهنده بسازیم.
الگوریتمهای مدلسازی موضوعی
مدلسازی موضوعی را میتوان با استفاده از الگوریتمها پیادهسازی کرد. این الگوریتمها عبارتاند از:
تخصیص نهفته دیریکله (LDA)
این الگوریتم محبوبترین الگوریتم برای مدلسازی موضوعی است. برای پیادهسازی مدلسازی موضوعی از مدلهای گرافی احتمالاتی استفاده میکند. برای استفاده از الگوریتم LDA در پایتون، باید بسته gensim را وارد کنیم.
تحلیل معنایی نهفته (LDA) یا نمایهسازی معنایی نهفته (LSI)
این الگوریتم بر پایه جبر خطی است. اساساً از مفهوم تجزیه مقادیر منفرد (SVD) روی ماتریس واژه و سند استفاده میکند.
تجزیه ماتریس نامنفی (NMF)
این الگوریتم نیز بر پایه جبر خطی است.
تمام الگوریتمهای مدلسازی موضوعی که در بالا ذکر شدند، پارامتری به نام تعداد موضوعات دارند، ماتریس سند-واژه را بهعنوان ورودی دریافت میکنند و ماتریس واژه-موضوع (WTM) و ماتریس موضوع-سند (TDM) را بهعنوان خروجی ارائه میدهند.
پیشرفت مطالعه: وضعیت خواندهشدن این درس فقط در همین مرورگر ذخیره میشود؛ بدون نیاز به حساب کاربری.