آموزش هوش مصنوعی با پایتون - یادگیری تحت نظارت (رگرسیون)
رگرسیون یکی از مهمترین ابزارهای آماری و یادگیری ماشین است. اگر بگوییم مسیر یادگیری ماشین از رگرسیون آغاز میشود، اشتباه نکردهایم. رگرسیون را میتوان یک روش پارامتری تعریف کرد که به ما امکان میدهد بر اساس دادهها تصمیمگیری کنیم یا به عبارت دیگر، با یادگیری رابطه بین متغیرهای ورودی و خروجی، بر اساس دادهها پیشبینی انجام دهیم. در اینجا، متغیرهای خروجی وابسته به متغیرهای ورودی، اعداد حقیقی با مقادیر پیوسته هستند. در رگرسیون، رابطه بین متغیرهای ورودی و خروجی اهمیت دارد و به ما کمک میکند بفهمیم با تغییر متغیر ورودی، مقدار متغیر خروجی چگونه تغییر میکند. رگرسیون به طور مکرر برای پیشبینی قیمتها، تحلیلهای اقتصادی، نوسانات و موارد دیگر استفاده میشود.
ساخت رگرسورها در پایتون
در این بخش، یاد میگیریم که چگونه رگرسورهای تکمتغیره و چندمتغیره بسازیم.
رگرسور خطی / رگرسور تکمتغیره
ابتدا چند پکیج مورد نیاز را وارد میکنیم −
import numpy as np
from sklearn import linear_model
import sklearn.metrics as sm
import matplotlib.pyplot as plt
اکنون باید دادههای ورودی را ارائه دهیم؛ ما دادههای خود را در فایلی به نام linear.txt ذخیره کردهایم.
input = 'D:/ProgramData/linear.txt'باید این دادهها را با استفاده از تابع np.loadtxt بارگذاری کنیم.
input_data = np.loadtxt(input, delimiter=',')
X, y = input_data[:, :-1], input_data[:, -1]
گام بعدی آموزش مدل خواهد بود. نمونههای آموزشی و آزمایشی را تعیین میکنیم.
training_samples = int(0.6 * len(X))
testing_samples = len(X) - num_training

X_train, y_train = X[:training_samples], y[:training_samples]

X_test, y_test = X[training_samples:], y[training_samples:]
حالا باید یک شیء رگرسور خطی ایجاد کنیم.
reg_linear = linear_model.LinearRegression()شیء را با نمونههای آموزشی، آموزش دهید.
reg_linear.fit(X_train, y_train)باید پیشبینی را با دادههای آزمایشی انجام دهیم.
y_test_pred = reg_linear.predict(X_test)حالا دادهها را رسم و تجسم کنید.
plt.scatter(X_test, y_test, color = 'red')
plt.plot(X_test, y_test_pred, color = 'black', linewidth = 2)
plt.xticks(())
plt.yticks(())
plt.show()
خروجی
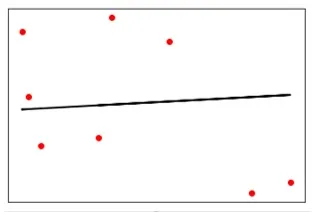
اکنون میتوانیم عملکرد رگرسیون خطی خود را به صورت زیر محاسبه کنیم −
print("Performance of Linear regressor:")
print("Mean absolute error =", round(sm.mean_absolute_error(y_test, y_test_pred), 2))
print("Mean squared error =", round(sm.mean_squared_error(y_test, y_test_pred), 2))
print("Median absolute error =", round(sm.median_absolute_error(y_test, y_test_pred), 2))
print("Explain variance score =", round(sm.explained_variance_score(y_test, y_test_pred),
2))
print("R2 score =", round(sm.r2_score(y_test, y_test_pred), 2))
خروجی
عملکرد رگرسور خطی −
Mean absolute error = 1.78
Mean squared error = 3.89
Median absolute error = 2.01
Explain variance score = -0.09
R2 score = -0.09
در کد بالا از این دادههای کوچک استفاده کردهایم. اگر مجموعه داده بزرگتری میخواهید، میتوانید از sklearn.dataset برای وارد کردن مجموعه دادههای بزرگتر استفاده کنید.
2,4.82.9,4.72.5,53.2,5.56,57.6,43.2,0.92.9,1.92.4,
3.50.5,3.41,40.9,5.91.2,2.583.2,5.65.1,1.54.5,
1.22.3,6.32.1,2.8
رگرسور چندمتغیره
ابتدا چند پکیج مورد نیاز را وارد میکنیم −
import numpy as np
from sklearn import linear_model
import sklearn.metrics as sm
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
اکنون باید دادههای ورودی را ارائه دهیم و دادههای خود را در فایلی به نام Mul_linear.txt ذخیره کردهایم.
input = 'D:/ProgramData/Mul_linear.txt'این دادهها را با استفاده از تابع np.loadtxt بارگذاری خواهیم کرد.
input_data = np.loadtxt(input, delimiter=',')
X, y = input_data[:, :-1], input_data[:, -1]
گام بعدی آموزش مدل خواهد بود؛ نمونههای آموزشی و آزمایشی را تعیین میکنیم.
training_samples = int(0.6 * len(X))
testing_samples = len(X) - num_training

X_train, y_train = X[:training_samples], y[:training_samples]

X_test, y_test = X[training_samples:], y[training_samples:]
حالا باید یک شیء رگرسور خطی ایجاد کنیم.
reg_linear_mul = linear_model.LinearRegression()شیء را با نمونههای آموزشی، آموزش دهید.
reg_linear_mul.fit(X_train, y_train)در نهایت، باید پیشبینی را با دادههای آزمایشی انجام دهیم.
y_test_pred = reg_linear_mul.predict(X_test)

print("Performance of Linear regressor:")
print("Mean absolute error =", round(sm.mean_absolute_error(y_test, y_test_pred), 2))
print("Mean squared error =", round(sm.mean_squared_error(y_test, y_test_pred), 2))
print("Median absolute error =", round(sm.median_absolute_error(y_test, y_test_pred), 2))
print("Explain variance score =", round(sm.explained_variance_score(y_test, y_test_pred), 2))
print("R2 score =", round(sm.r2_score(y_test, y_test_pred), 2))
خروجی
عملکرد رگرسور خطی −
Mean absolute error = 0.6
Mean squared error = 0.65
Median absolute error = 0.41
Explain variance score = 0.34
R2 score = 0.33
اکنون یک چندجملهای درجه ۱۰ ایجاد میکنیم و رگرسور را آموزش میدهیم. نقطهداده نمونه را وارد خواهیم کرد.
polynomial = PolynomialFeatures(degree = 10)
X_train_transformed = polynomial.fit_transform(X_train)
datapoint = [[2.23, 1.35, 1.12]]
poly_datapoint = polynomial.fit_transform(datapoint)

poly_linear_model = linear_model.LinearRegression()
poly_linear_model.fit(X_train_transformed, y_train)
print("\nLinear regression:\n", reg_linear_mul.predict(datapoint))
print("\nPolynomial regression:\n", poly_linear_model.predict(poly_datapoint))
خروجی
رگرسیون خطی −
[2.40170462]رگرسیون چندجملهای −
[1.8697225]در کد بالا از این دادههای کوچک استفاده کردهایم. اگر مجموعه داده بزرگتری میخواهید، میتوانید از sklearn.dataset برای وارد کردن مجموعه دادههای بزرگتر استفاده کنید.
2,4.8,1.2,3.22.9,4.7,1.5,3.62.5,5,2.8,23.2,5.5,3.5,2.16,5,
2,3.27.6,4,1.2,3.23.2,0.9,2.3,1.42.9,1.9,2.3,1.22.4,3.5,
2.8,3.60.5,3.4,1.8,2.91,4,3,2.50.9,5.9,5.6,0.81.2,2.58,
3.45,1.233.2,5.6,2,3.25.1,1.5,1.2,1.34.5,1.2,4.1,2.32.3,
6.3,2.5,3.22.1,2.8,1.2,3.6
پیشرفت مطالعه: وضعیت خواندهشدن این درس فقط در همین مرورگر ذخیره میشود؛ بدون نیاز به حساب کاربری.